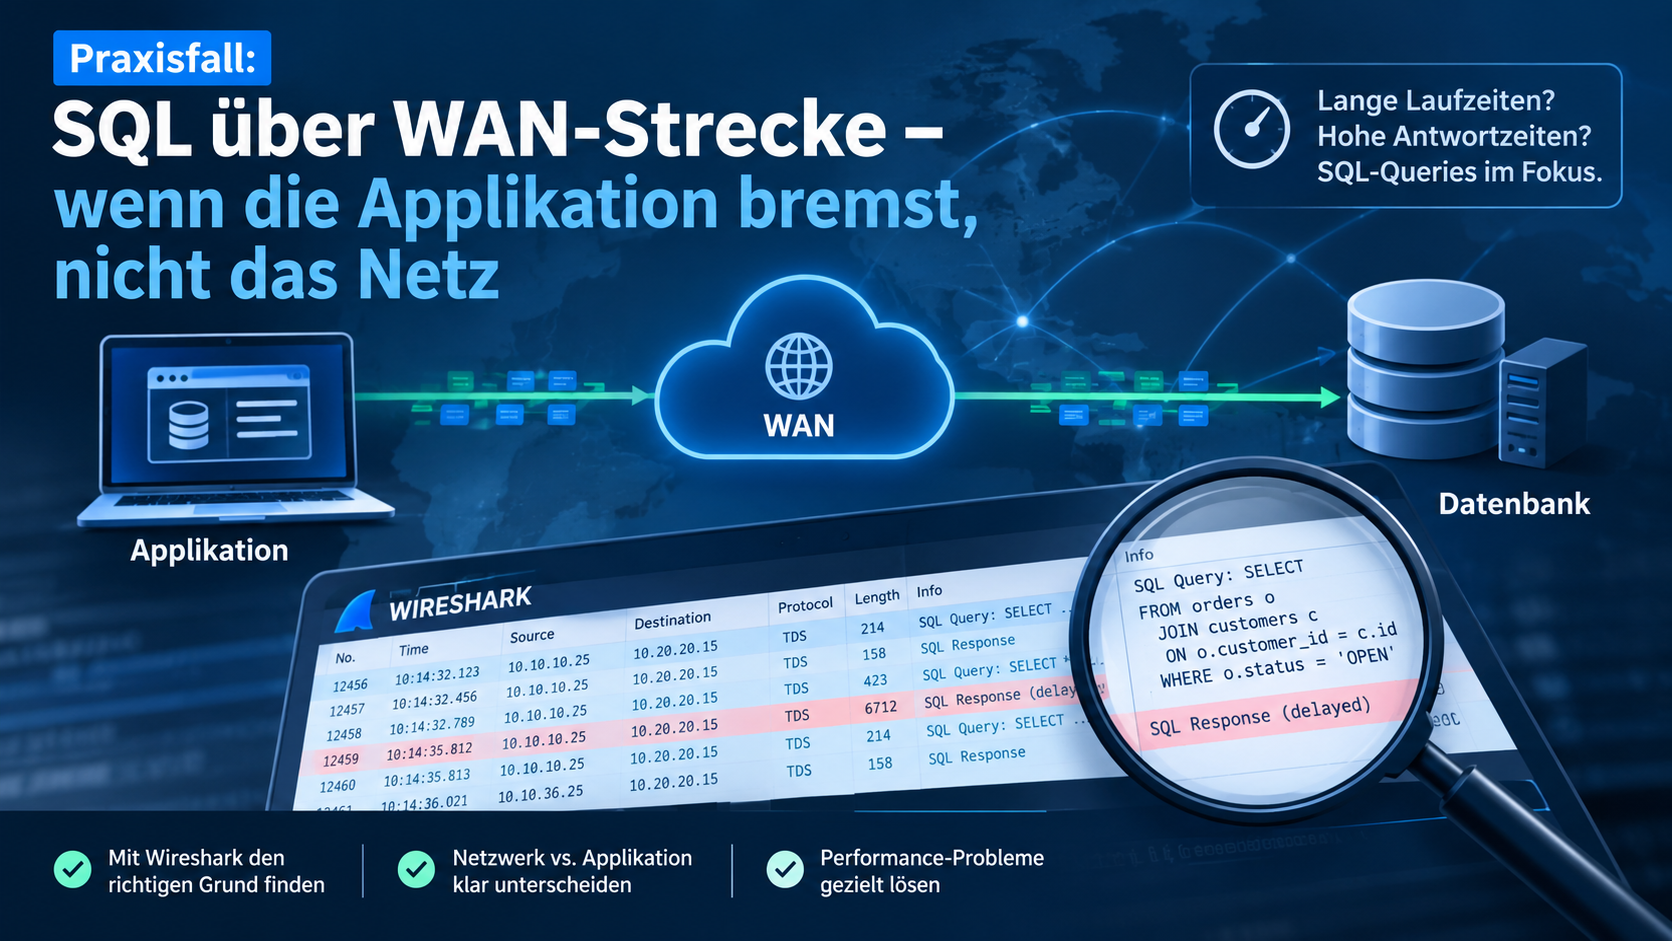
Praxisfall: SQL über WAN-Strecke – wenn die Applikation bremst, nicht das Netz
„Das Netz ist schuld.“ Diesen Satz hört man in IT-Projekten erstaunlich oft – und meistens zu früh. Besonders bei verteilten Anwendungsarchitekturen über WAN-Strecken ist es verlockend, die Netzwerkverbindung als Ursache für Performance-Einbrüche zu benennen. Schließlich liegt sie irgendwo zwischen den Systemen, ist schwer sichtbar und noch schwerer zu beweisen.
Dieser Praxisfall zeigt, wie eine strukturierte Netzwerkanalyse mit Wireshark dabei hilft, genau diese Schuldfrage sauber zu beantworten – und warum die Antwort manchmal überraschend klar ausfällt.
Das Wichtigste in Kürze
- Symptom: Eine geschäftskritische Citrix-Anwendung friert mehrmals täglich für 2 bis 30 Sekunden ein – bei allen Benutzern gleichzeitig.
- Verdacht: Die WAN-Strecke zur externen Datenbank eines Drittanbieters.
- Ergebnis: Das Netz ist unauffällig. Die Pausen gehen vom Applikationsserver aus, der in diesen Momenten schlicht keine neuen Anfragen stellt.
- Nebenbefund: Die Verbindungsarchitektur zur externen Datenbank wird unter hoher Last zum Engpass – ein eigenständiges Risiko, aber nicht die Ursache der Einfrierer.
Die Ausgangssituation: Einfrieren ohne offensichtliche Ursache
Das Szenario ist typisch für mittelständische IT-Umgebungen: Eine geschäftskritische Anwendung wird über eine Citrix-Farm bereitgestellt. Sie läuft stabil – bis auf ein wiederkehrendes Phänomen, das die Anwender zunehmend frustriert: Die Anwendung friert mehrmals täglich ein, für Zeiträume zwischen zwei und dreißig Sekunden.
Auffällig dabei ist, dass das Problem alle Benutzer gleichzeitig trifft, unabhängig davon, auf welchem Terminalserver ihre Sitzung läuft. Noch merkwürdiger: Das Einfrieren tritt auch dann auf, wenn die Anwender gerade gar nichts tun – also zum Beispiel telefonieren und nur auf den Bildschirm schauen. Das deutet früh darauf hin, dass es sich nicht um ein benutzerspezifisches Problem handelt, sondern um etwas im Hintergrund – eine gemeinsam genutzte Komponente, an der alle Sitzungen hängen.
Die Architektur hinter der Anwendung ist eine klassische dreistufige Konstellation: Ein Applikationsserver im lokalen Rechenzentrum kommuniziert mit einem Linked DB Server, der wiederum Datenbankabfragen an einen externen DB Server eines Drittanbieters weiterleitet – über eine WAN-Verbindung. Diese Architektur ist grundsätzlich nichts Ungewöhnliches, birgt aber typische Fallstricke, die sich bei der Analyse schnell zeigen.
Die Methodik: Aufzeichnung zum Fehlerzeitpunkt
Bevor man mit der Analyse anfängt, ist eine saubere Aufzeichnung entscheidend. Der Mitschnitt muss an der richtigen Stelle im Netzwerk platziert werden – idealerweise dort, wo der verdächtige Datenverkehr vorbeiläuft, also am Linked DB Server, der die zentrale Vermittlungsstelle zwischen den beiden Umgebungen darstellt.
Dabei sollte man sich der Grenzen jedes Messpunkts bewusst sein: Ein Mitschnitt zeigt nur den Verkehr, der an genau dieser Stelle vorbeiläuft. Was der Applikationsserver mit anderen Systemen bespricht, bleibt von hier aus unsichtbar. Dazu später mehr.
Entscheidend ist außerdem, die Fehlerzeitpunkte von den Anwendern dokumentieren zu lassen. Nicht vage („irgendwann am Morgen“), sondern so präzise wie möglich. Nur so lässt sich der Mitschnitt später gezielt filtern und der relevante Zeitraum isolieren. In der Praxis kommt es immer wieder vor, dass Traces über Stunden oder Tage laufen – und der eigentlich interessante Moment sich auf wenige Sekunden konzentriert.
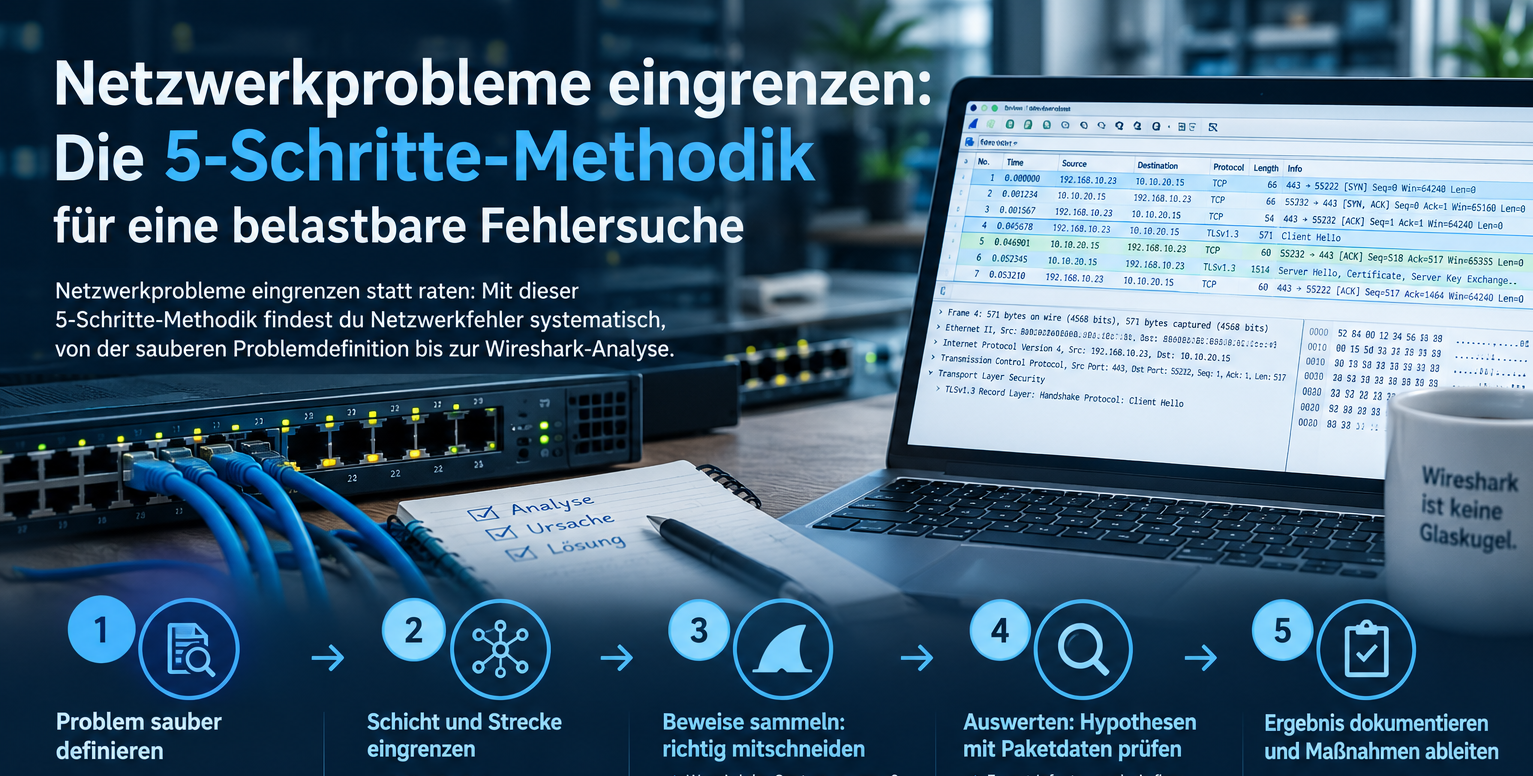
Wenn du tiefer in die Methodik einer strukturierten Aufzeichnung einsteigen möchtest, empfehle ich dir den Artikel Netzwerkprobleme systematisch eingrenzen, der den gesamten Analyse-Workflow beschreibt.
Der erste Blick: Was zeigt die Übertragungskurve?
Ein guter Einstieg in jeden Mitschnitt ist die Übertragungskurve – in Wireshark der I/O-Graph unter Statistiken. Er zeigt, wie viele Daten über die Zeit übertragen werden. Hier erkennt man auf Anhieb, ob es Einbrüche, Pausen oder Auffälligkeiten gibt, die zeitlich mit dem gemeldeten Fehlerzeitpunkt korrelieren.
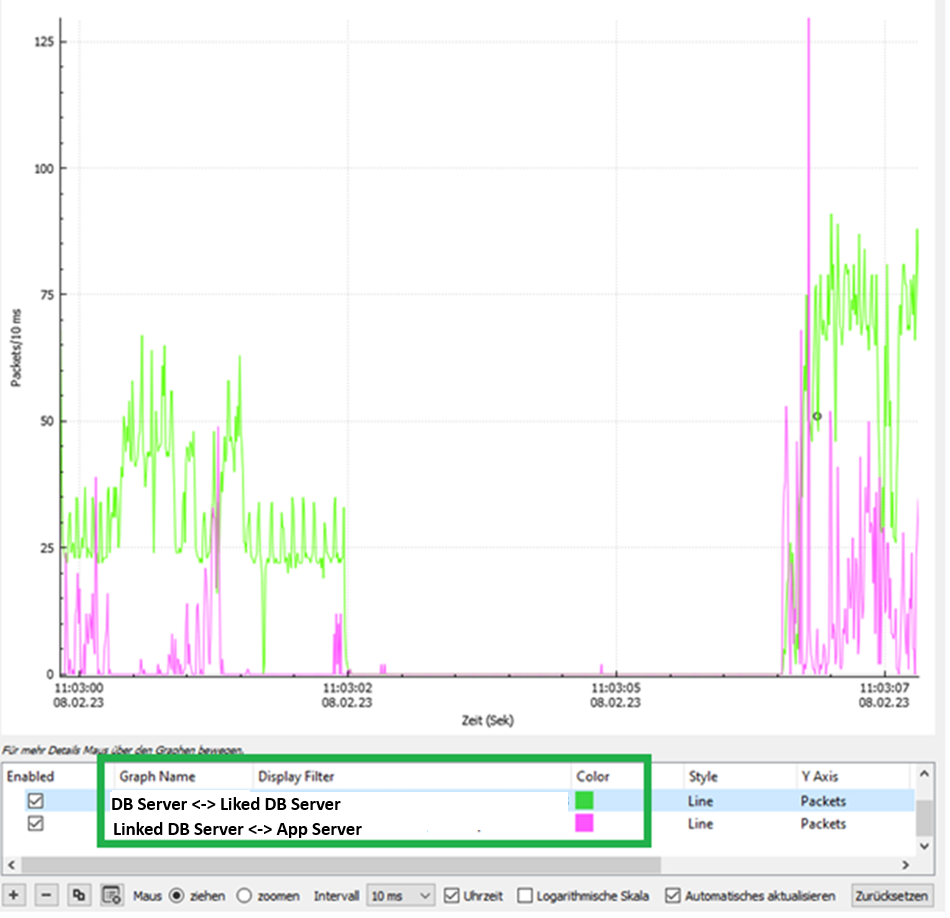
In diesem Fall war die Übertragungskurve eindeutig: Zum gemeldeten Fehlerzeitpunkt bricht die Übertragung für mehrere Sekunden nahezu vollständig ein. Das ist ein klares Signal, dem man nachgehen muss.
Die entscheidende Frage ist jetzt: Wer ist verantwortlich für diese Pause? Das Netz? Der Server? Die Applikation?
Die Analyse auf TCP-Ebene: Wer schweigt hier?
Um das zu beantworten, filtert man den Mitschnitt auf die betroffenen TCP-Sitzungen – etwa mit tcp.stream eq 12 für einen einzelnen Stream – und schaut sich die Kommunikation im Detail an. Besonders hilfreich ist dabei die TCP Delta Time (tcp.time_delta), also die Zeit zwischen zwei aufeinanderfolgenden Paketen innerhalb derselben TCP-Verbindung. Damit Wireshark dieses Feld berechnet, muss in den TCP-Protokolleinstellungen die Option Calculate conversation timestamps aktiviert sein.
Mit folgendem Filter springst du direkt zu allen Stellen, an denen eine Verbindung länger als eine Sekunde geschwiegen hat:
tcp.time_delta > 1
Wenn du wissen willst, wie man TCP-Streams grundsätzlich liest und interpretiert, ist der Artikel Wie lese ich einen TCP Stream richtig? eine gute Ergänzung zu diesem Praxisfall.
Im konkreten Fall zeigt sich bei genauem Hinsehen etwas Interessantes: Während der Übertragungspause sendet der Applikationsserver selbst keine SQL-Requests. Der Linked DB Server antwortet korrekt und zeitnah auf die vorherigen Anfragen. Der App Server quittiert diese Antworten ordnungsgemäß – und macht dann einfach eine Pause. Er stellt für mehrere Sekunden gar keine neuen Anfragen.
Das ist ein wichtiger Befund: Das Netz schweigt, weil der Absender schweigt – nicht weil das Netz blockiert ist.
Genau diesen Unterschied kann eine reine Monitoring-Kurve nicht zeigen. Sie sieht nur, dass nichts übertragen wird. Erst der Blick auf Paketebene zeigt, wer gerade am Zug wäre – und wer stattdessen wartet.
Netzwerklaufzeit und Response Time: Das Netz ist unauffällig
Um sicherzugehen, dass keine versteckten Netzprobleme vorliegen, schaut man sich die klassischen Kennzahlen an.
Die Netzwerklaufzeit (RTT) wird am elegantesten beim TCP-Sitzungsaufbau gemessen – am sogenannten TCP Three-Way Handshake. Beim SYN/SYN-ACK/ACK-Austausch gibt es noch keine Applikationslogik, die Verarbeitungszeit verursacht. Was man hier misst, ist praktisch reine Netzwerklaufzeit. Wireshark weist diesen Wert pro Verbindung direkt im Feld tcp.analysis.initial_rtt aus.
Bei langlebigen Verbindungen – etwa durch Connection Pooling – ist der Handshake oft gar nicht im Mitschnitt enthalten. Dann hilft tcp.analysis.ack_rtt weiter, also die Zeit zwischen einem Datensegment und seiner Bestätigung. Achtung: Delayed ACKs können diesen Wert künstlich erhöhen, deshalb ist er eher ein Richtwert. Wie du RTT-Werte grundsätzlich einordnest, erkläre ich ausführlich im Artikel Hohe Latenz im Firmennetz – RTT analysieren.
In diesem Fall liegt die durchschnittliche Netzwerklaufzeit zwischen Applikationsserver und Linked DB Server im lokalen Rechenzentrum im Bereich von unter 0,1 ms – ein vollkommen unauffälliger Wert für eine LAN-Verbindung. Die WAN-Strecke zum externen DB Server zeigt etwas höhere Werte, wie es für eine dedizierte Standleitung zu erwarten ist – aber auch hier nichts, was als Problem gewertet werden müsste.
Die Server Response Time – also die Zeit, die ein Server benötigt, um auf eine Anfrage zu antworten – ist in den Fehlerzeiträumen ebenfalls unauffällig. Die letzten Anfragen vor jeder Pause hat der Linked DB Server zeitnah beantwortet. Es gibt keine Ausreißer, die auf Überlast oder Verarbeitungsprobleme hindeuten würden.
TCP Retransmissions: Erklären sie die Pausen?
Ein weiterer klassischer Indikator für Netzprobleme sind TCP Retransmissions. Sie entstehen, wenn der Sender davon ausgehen muss, dass Daten nicht angekommen sind, und sie deshalb erneut überträgt.
Einen schnellen Überblick über alle TCP-Auffälligkeiten im Mitschnitt verschafft dir dieser Filter:
tcp.analysis.retransmission || tcp.analysis.fast_retransmission || tcp.analysis.duplicate_ack || tcp.analysis.zero_window
Im Mitschnitt tauchten einige Retransmissions auf, die Wireshark als TCP Fast Retransmission markiert hat. Eine Fast Retransmission entsteht, wenn der Empfänger mehrere Duplicate ACKs schickt und damit signalisiert, dass in der Sequenznummernfolge eine Lücke ist. Die Ursache kann ein verlorenes Segment sein, aber auch Pakete, die in vertauschter Reihenfolge ankommen (Reordering).
Für diesen Fall ist aber eine andere Frage entscheidend: Können die Retransmissions die Pausen erklären? Die Antwort ist eindeutig nein – aus zwei Gründen:
- Eine Fast Retransmission ist schnell. Sie kostet ungefähr eine Round Trip Time. Im LAN sind das Bruchteile einer Millisekunde, keine Sekunden.
- Zu Beginn jeder Pause war alles quittiert. Es gab keine offenen, unbestätigten Daten, auf deren Wiederholung jemand hätte warten können. Wo nichts gesendet wird, kann auch nichts verloren gehen.
Ein echter Stillstand durch Paketverlust sähe im Trace anders aus: Der Sender hat unbestätigte Daten offen, wartet bis zum Retransmission Timeout (RTO) – mindestens rund 200 bis 300 ms, bei wiederholtem Verlust exponentiell länger – und sendet dann erneut. Genau dieses Muster fehlt hier.
Wer den Unterschied zwischen TCP Fast Retransmission, Dup ACKs und Out-of-Order-Paketen genauer verstehen möchte, findet dazu eine ausführliche Erklärung in: TCP Retransmissions, Dup ACKs & Out-of-Order – Unterschiede.
TCP Zero Window Events (tcp.analysis.zero_window) – also Situationen, in denen ein Empfänger seinen Eingangspuffer nicht schnell genug leert und den Sender ausbremst – wurden im gesamten Mitschnitt nicht ein einziges Mal erfasst. Auch das spricht klar gegen ein Netzwerk- oder Kapazitätsproblem. Wie das TCP-Empfangsfenster funktioniert, erkläre ich in TCP Window Size & Scaling einfach erklärt.
Die Server-Analyse: Ein Engpass unter Last
Interessant wird es bei der Auswertung der simultanen Requests. Zwischen Linked DB Server und dem externen DB Server bestanden während des Aufzeichnungszeitraums nur wenige parallele TCP-Sitzungen. Da SQL-Requests innerhalb einer TCP-Sitzung in der Regel sequenziell abgearbeitet werden – also eine Anfrage nach der anderen (bei MS SQL gilt das, solange kein MARS, also Multiple Active Result Sets, genutzt wird) –, ist die maximale Parallelität durch die Anzahl der offenen Verbindungen begrenzt.
Zwischen Applikationsserver und Linked DB Server gab es deutlich mehr gleichzeitige Verbindungen und entsprechend mehr simultane Requests. Sobald die Zahl der simultanen Anfragen jedoch die Kapazität der Verbindungen zum externen DB Server übersteigt, steigt die durchschnittliche Antwortzeit spürbar an. Hier entsteht ein Engpass – nicht weil das Netz zu langsam ist, sondern weil die Anzahl der parallelen Verbindungen zur Datenbank die Menge der eingehenden Anfragen nicht aufnehmen kann.
Das ist kein Netzwerkproblem. Es ist ein Architektur- und Konfigurationsproblem: zu wenige parallele Verbindungen für die Last, die die Applikation erzeugt.
Wichtig für die Einordnung: Dieser Engpass ist nicht die Ursache der Einfrierer. Wäre er es, sähe man im Trace offene Anfragen, auf deren Antwort der App Server wartet. Stattdessen hat er in den Pausen gar nichts angefragt. Der Engpass ist ein eigenständiges Risiko, das unter Last zu spürbar längeren Antwortzeiten führt – und das man unabhängig vom eigentlichen Problem angehen sollte.
Das Gesamtbild: Was sagt der Trace wirklich aus?
Am Ende der Analyse ergibt sich ein klares Bild:
| Prüfpunkt | Wireshark-Feld | Befund | Bewertung |
|---|---|---|---|
| Pausen im TCP-Stream | tcp.time_delta |
App Server stellt keine neuen Requests, alle Antworten sind quittiert | Pause geht vom App Server aus |
| Netzwerklaufzeit LAN | tcp.analysis.initial_rtt |
Unter 0,1 ms | Unauffällig |
| Netzwerklaufzeit WAN | tcp.analysis.initial_rtt |
Etwas höher, typisch für eine Standleitung | Unauffällig |
| Retransmissions | tcp.analysis.fast_retransmission |
Einige Fast Retransmissions, kein RTO-Stillstand | Erklären die Pausen nicht |
| Zero Window | tcp.analysis.zero_window |
Kein einziges Ereignis | Kein Pufferengpass |
| Parallele Sitzungen zur externen DB | tcp.stream |
Wenige Sitzungen, Antwortzeit steigt unter Last | Nebenbefund: Architektur |
Kurz gesagt: Das Netz ist unauffällig, die Pausen entstehen auf dem Applikationsserver. Was dort konkret passiert – ob interne Verarbeitungslogik, Timer, Sperrmechanismen oder andere applikationsseitige Ursachen –, lässt sich allein aus diesem Netzwerktrace nicht abschließend klären.
Die nächsten Schritte: Den Applikationsserver ins Visier nehmen
Der Trace hat die Suche eingegrenzt. Jetzt geht es darum, auf dem Applikationsserver selbst nachzusehen. In der Praxis haben sich dafür diese Schritte bewährt:
- Zweiter Messpunkt direkt am Applikationsserver: Spricht der Server während der Pause mit anderen Systemen – DNS, Active Directory, Fileserver, Lizenzserver? Wartet er dort auf eine Antwort, sieht man das nur an diesem Messpunkt.
- Zeitstempel abgleichen: Applikations-Logs, Windows-Ereignisanzeige und Performance-Counter (CPU, Threads, Speicher) sekundengenau auf die dokumentierten Pausen legen.
- Muster in den Fehlerzeiten suchen: Treten die Einfrierer in festen Abständen auf, deutet das auf Timer, geplante Tasks oder Hintergrundjobs der Applikation hin.
- Infrastruktur nicht vergessen: Auch VM-Snapshots im Rahmen der Datensicherung können eine virtuelle Maschine für Sekunden anhalten (Stun). Ein Abgleich mit den Backup-Zeitplänen kostet wenig und schließt eine häufige Ursache aus.
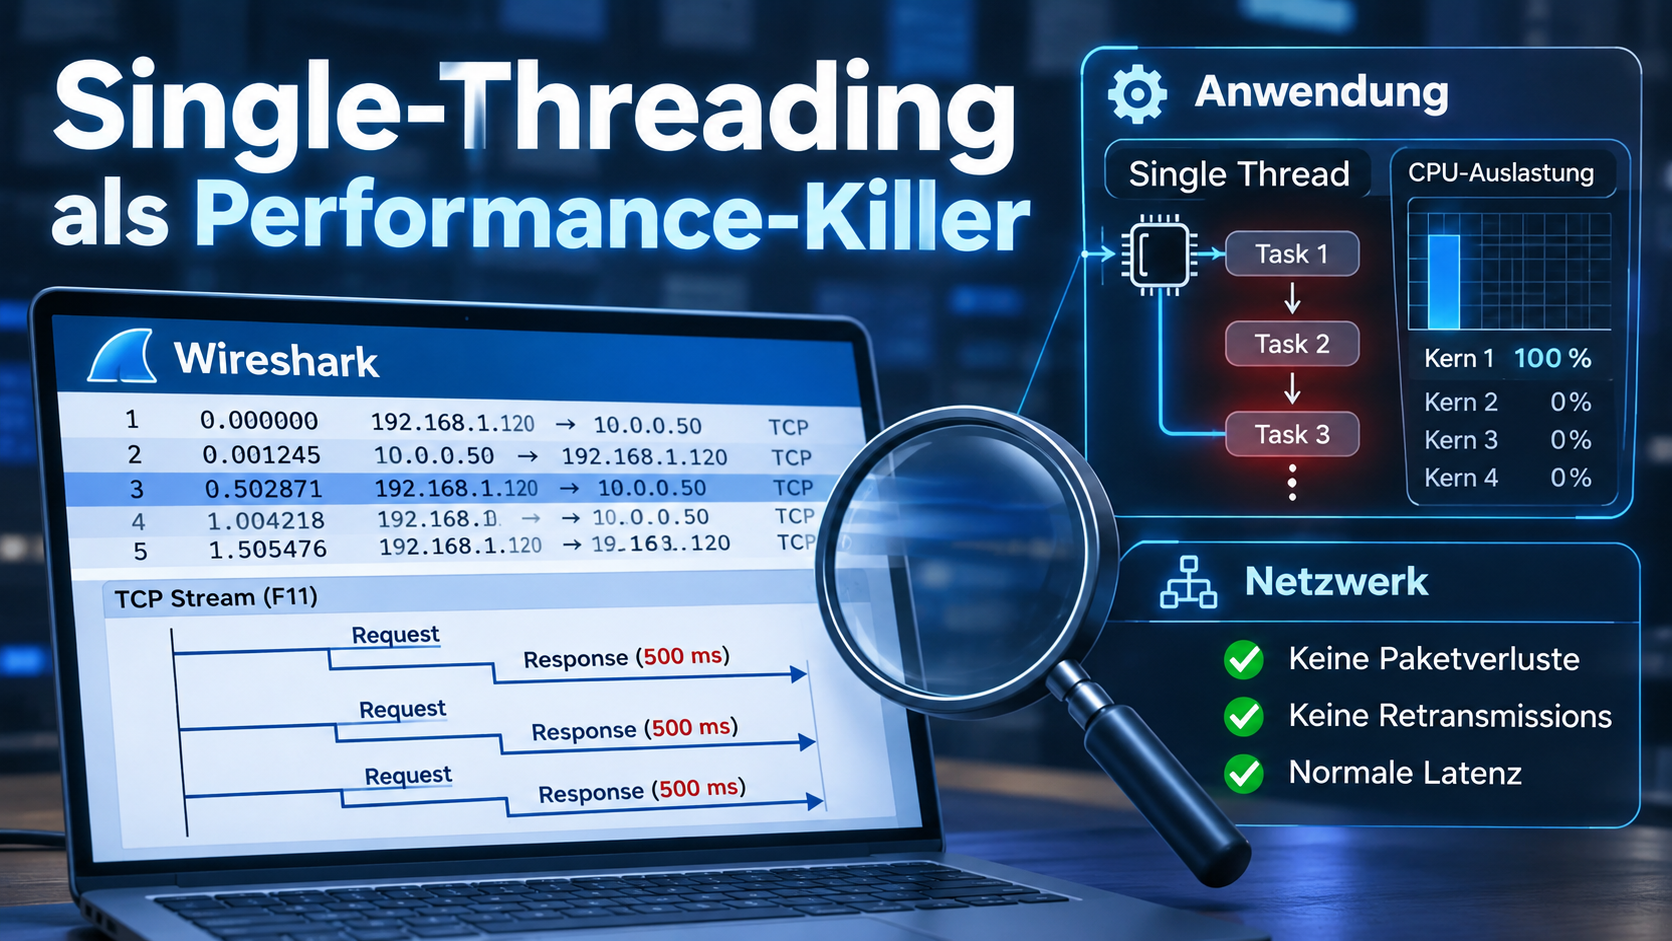
Arbeitet die Applikation Anfragen intern nur über einen einzigen Thread ab, kann ein ähnliches Bild entstehen: Ein langsamer Vorgang blockiert alles dahinter. Wie sich das im Trace zeigt, beschreibe ich im Praxisfall Single-Threading als Performance-Killer.
Was man aus diesem Praxisfall mitnehmen kann
Dieser Fall ist ein gutes Beispiel dafür, wie wertvoll eine saubere Netzwerkanalyse als Ausschlussverfahren ist. Manchmal besteht das Ergebnis nicht darin, das Problem zu finden – sondern darin, klar zu belegen, wo es nicht liegt.
Das klingt auf den ersten Blick unbefriedigend. In der Praxis ist es aber das Gegenteil: Ein sauber dokumentierter Nachweis, dass das Netzwerk keine Ursache ist, spart enorme Zeit. Er verhindert, dass IT-Teams wochenlang an der falschen Stelle suchen, unnötige Hardware beschafft wird oder Dienstleister beauftragt werden, ein Problem zu lösen, das gar nicht bei ihnen liegt.
Gleichzeitig gibt der Trace konkrete Hinweise: Die Pause liegt auf dem Applikationsserver, und die Verbindungsarchitektur zur Datenbank zeigt einen potenziellen Engpass bei hoher Last. Das sind verwertbare Erkenntnisse, die das weitere Vorgehen gezielt steuern – und die Diskussion zwischen Netzwerk- und Applikationsteam auf eine sachliche Grundlage stellen.
Typische Fehler bei WAN-SQL-Szenarien
In der Praxis begegnen mir bei ähnlichen Architekturen immer wieder die gleichen Muster, die Performance-Probleme verursachen:
- Zu wenige parallele Datenbankverbindungen – die Applikation erzeugt mehr Last, als der Connection Pool verarbeiten kann.
- Sequentielle statt parallele Abfragen – Abfragen werden nacheinander abgesetzt, obwohl sie unabhängig voneinander wären.
- Chatty Application Patterns – die Anwendung sendet viele kleine Anfragen statt wenige effiziente, was über WAN-Strecken besonders stark ins Gewicht fällt.
- Fehlkonfigurierte Prefetch-Größen – der Datenbankclient holt Zeilen einzeln statt in Blöcken, was die Round Trips multipliziert.
Warum diese Muster über WAN so viel stärker wehtun als im LAN, zeigt eine einfache Rechnung:
Wartezeit ≈ Anzahl sequenzieller Abfragen × RTT
500 nacheinander abgesetzte Abfragen kosten im LAN bei 0,1 ms RTT gerade einmal 50 ms. Über eine WAN-Strecke mit 15 ms RTT sind es bereits 7,5 Sekunden – ohne dass am Netz irgendetwas defekt wäre.
Einige dieser Muster – insbesondere das N+1-Query-Problem und sequentielle DB-Requests – werden in einem eigenen Praxisfall ausführlich behandelt: Praxisfall: Sequentielle DB-Requests & N+1 Query.
Fazit: Wireshark als Beweismittel, nicht nur als Tool
Was diesen Praxisfall besonders lehrreich macht, ist nicht die Komplexität des Problems – sondern die Klarheit, mit der Wireshark die Ursache eingrenzt. Der Mitschnitt lügt nicht. Er zeigt objektiv, wer wann sendet, wer wartet und wo Verzögerungen entstehen.
Das macht Paketanalyse zu einem der wenigen Werkzeuge in der IT, das tatsächlich als Beweismittel taugt – nicht nur als Diagnosehelfer. Gerade in Situationen, in denen mehrere Teams beteiligt und Zuständigkeiten ungeklärt sind, ist das unbezahlbar.
Wenn du vermutest, dass dein Netzwerk langsam ist, aber nicht weißt, wo genau der Flaschenhals liegt – genau dafür ist eine strukturierte Analyse da. Nicht um Schuldige zu suchen, sondern um Klarheit zu schaffen.
Hast du ähnliche Performance-Probleme in deiner Umgebung? Ob du als Admin zwischen Netzwerk- und Applikationsteam vermittelst, als Applikationsverantwortlicher wissen willst, wo die Zeit wirklich verloren geht, oder als IT-Leiter eine belastbare Entscheidungsgrundlage brauchst: Eine Paketanalyse liefert Fakten statt Vermutungen. Schreib mir über das Kontaktformular und schildere kurz dein Problem. Das Erstgespräch ist kostenlos – danach weißt du, ob und wie eine Analyse in deinem Fall weiterhilft. Einen Überblick über meine Arbeit findest du unter Leistungen.