Single-Threading als Performance-Killer: Wenn die Anwendung bremst, nicht das Netzwerk
Inhaltsverzeichnis
ToggleEs gibt einen Satz, den ich in den letzten Jahren in fast jedem zweiten Eskalationsmeeting gehört habe: „Das Netzwerk ist zu langsam.“ Meistens fällt er in der ersten Minute, oft noch bevor überhaupt jemand einen Trace gezogen hat. Und erstaunlich oft ist er falsch – nicht böswillig falsch, sondern strukturell falsch. Die Symptome, die Anwender wahrnehmen, sehen verdächtig nach einem Netzwerkproblem aus, obwohl die eigentliche Ursache im Kommunikationsverhalten der Anwendung liegt.
In diesem Artikel zeige ich dir, wie du Single-Threading- und Serialisierungsprobleme im Wireshark-Trace zuverlässig von echten Netzwerkproblemen unterscheidest: mit konkreten Merkmalen, den passenden Wireshark-Feldern, einer Vergleichstabelle und einem anonymisierten Praxisfall aus einer typischen WAN-Anbindung. Und du erfährst, wie du die Zeit eines langsamen Vorgangs so zerlegst, dass am Ende niemand mehr raten muss, wo sie verloren geht.
Der Ausgangspunkt: „Das Netzwerk ist zu langsam“
Das Szenario kennst du vermutlich in einer der folgenden Varianten: Eine Fachabteilung beschwert sich, dass ein internes Tool, ein ERP-Modul oder eine Web-Anwendung „ewig lädt“. Der Vorgang, der früher zwei Sekunden dauerte, braucht jetzt zehn oder zwanzig. Die IT-Leitung fragt beim Netzwerkteam nach, das Netzwerkteam schaut sich die Interface-Auslastung an, sieht nichts Auffälliges – und schickt die Anfrage postwendend an die Entwicklung zurück. Die Entwicklung wiederum sagt, der Code habe sich nicht geändert, also müsse es am Netzwerk liegen. Ping und Traceroute sehen unauffällig aus. Die Bandbreite ist zu keinem Zeitpunkt ausgereizt.
Genau an diesem Punkt entsteht das klassische Fingerpointing: Beide Teams haben recht mit dem, was sie sehen – und trotzdem bringt keine der beiden Sichtweisen die Lösung näher. Was fehlt, ist der Blick auf die Interaktion zwischen Anwendung und Netzwerk. Und genau den liefert ein sauberer Paket-Trace. Ohne ihn endet die Diskussion erfahrungsgemäß nicht selten mit einer teuren Bandbreitenerhöhung, die am Problem exakt nichts ändert.
Denn die Ursache liegt in vielen dieser Fälle nicht in der Leitung, sondern im Kommunikationsmuster der Anwendung: Sie spricht seriell statt parallel mit dem Server. Jeder Request wartet, bis der vorherige komplett beantwortet ist – und jede einzelne Umlaufzeit addiert sich zur nächsten, statt sich zu überlappen.
Was „Single-Threading“ im Trace eigentlich bedeutet
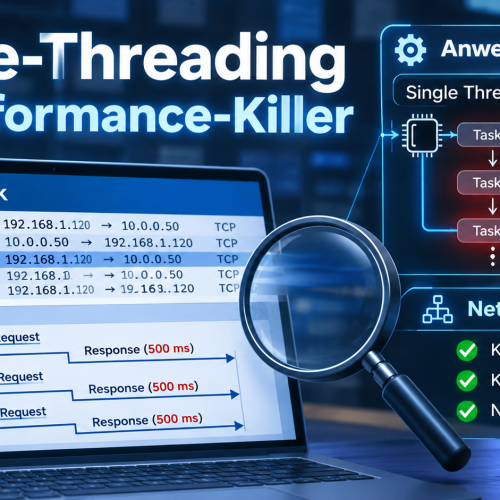
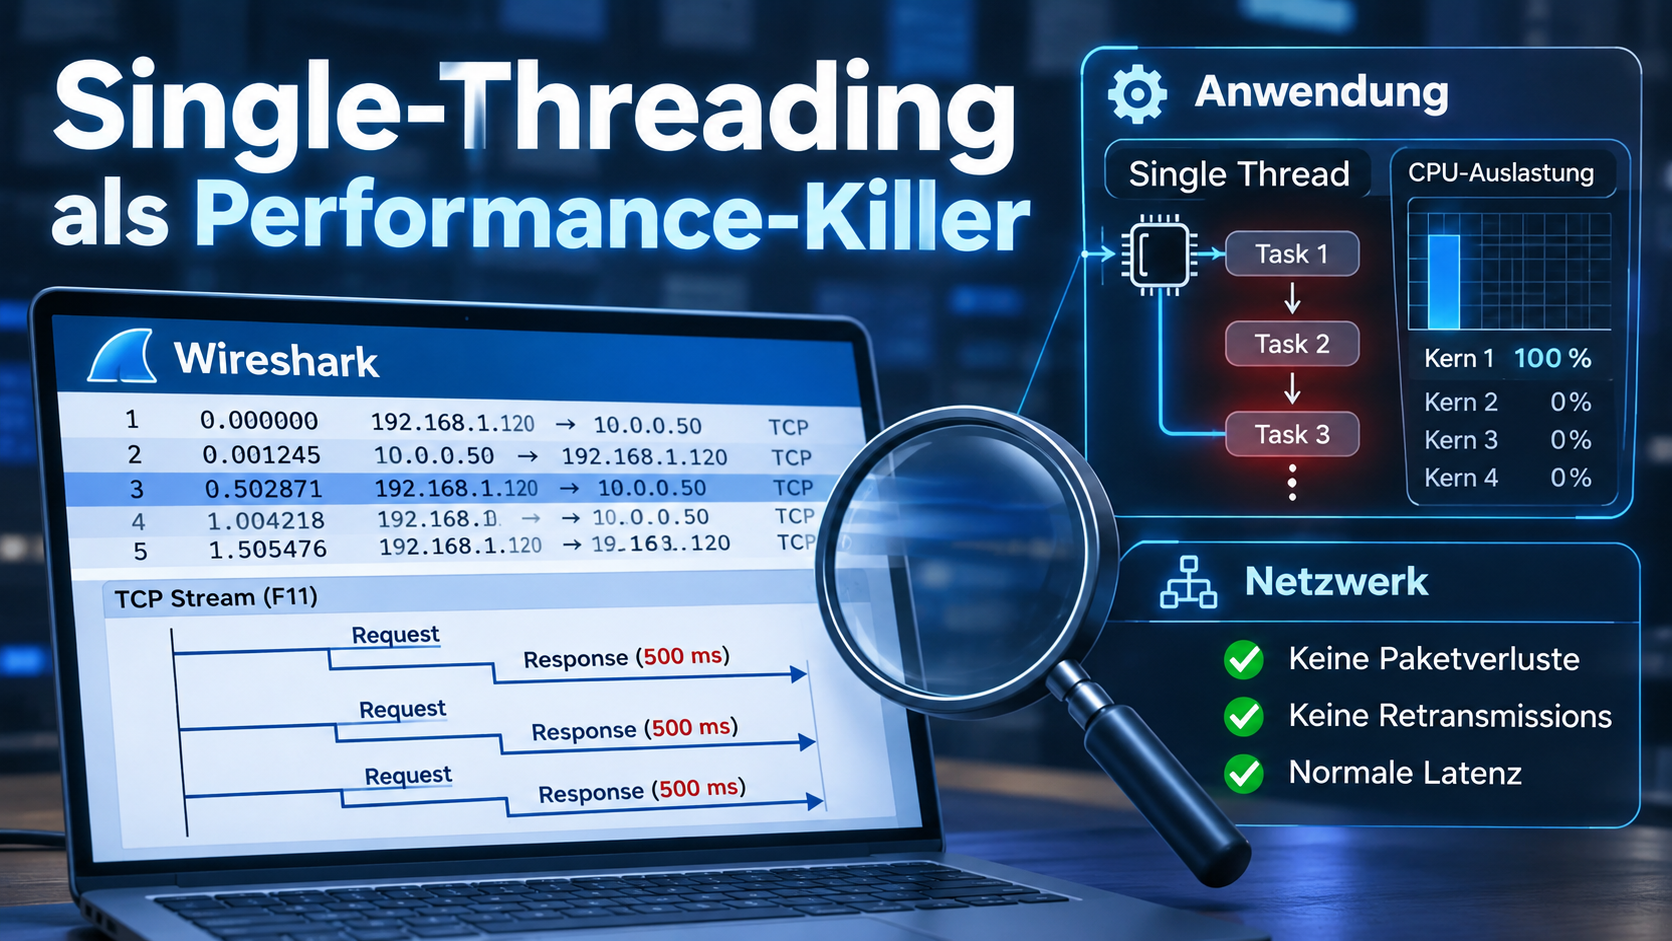
Kurz zur Begriffsklärung, weil das in Meetings oft durcheinandergeht: Im Trace siehst du keine Threads. Was du siehst, ist das Ergebnis – eine Anwendung, die immer nur eine Anfrage gleichzeitig offen hat. Ob dahinter tatsächlich ein einzelner Thread steckt, synchron programmierte API-Aufrufe oder eine Schleife, die pro Datensatz einen eigenen Request absetzt, ist aus Netzwerksicht zweitrangig. Das Muster ist dasselbe: Request, warten, Response, nächster Request. Jeder dieser Durchläufe ist ein sogenannter Turn (auch: Application Turn).
In der Praxis begegnen dir dabei zwei Ausprägungen, die du auseinanderhalten solltest:
- Die „geschwätzige“ Anwendung (chatty): Der Client feuert den nächsten Request fast sofort ab, sobald die Antwort da ist. Die Zeit geht nicht beim Client verloren, sondern in der schieren Anzahl der Turns – jeder kostet mindestens eine RTT. Im LAN fällt das kaum auf, über das WAN wird es zum Problem.
- Die „nachdenkliche“ Anwendung: Zwischen Response und nächstem Request vergeht spürbar Zeit, weil Client oder Server zwischendurch rechnen, rendern oder auf etwas anderes warten. Hier ist die Pause selbst der Zeitfresser – unabhängig davon, wie schnell das Netz ist.
Beide Varianten haben eines gemeinsam: Das Netzwerk arbeitet sauber und liefert genau die Laufzeit, die die Strecke physikalisch hergibt. Wie du das im Trace belegst, schauen wir uns jetzt an.
Was der Wireshark-Trace wirklich zeigt
Wenn ich in so einer Situation dazugerufen werde, ziehe ich als Erstes einen Trace auf Client- und – wo möglich – parallel auf Serverseite. Schon beim ersten Blick auf die Paketliste fallen bei einem Serialisierungsproblem einige Muster auf, die sich deutlich von einem „echten“ Netzwerkproblem unterscheiden.
Sequentielle Request-Response-Zyklen statt Überlappung
Filterst du auf die betroffene Verbindung, siehst du ein sehr regelmäßiges Muster: Request, Response, nächster Request, nächste Response. Kein Überlappen, kein zweiter Request, solange der erste noch offen ist. Die Stream-Nummer der Verbindung findest du in jedem Paket im Feld tcp.stream – die 0 im Filter ersetzt du einfach durch deine:
tcp.stream eq 0
Wichtig dabei: Eine einzige TCP-Verbindung ist noch kein Beweis für serielle Verarbeitung. Moderne Anwendungen mit HTTP/2 bündeln bewusst viele parallele Anfragen über eine Verbindung (Multiplexing), unterscheidbar am Feld http2.streamid. Und bei HTTP/1.1 öffnen Browser typischerweise bis zu sechs Verbindungen pro Server. Entscheidend ist deshalb nicht die Anzahl der Verbindungen, sondern die Frage: Sind jemals mehrere Requests gleichzeitig unterwegs?
Das prüfst du auf zwei Wegen. Unter Statistics → Conversations im Reiter TCP zeigen dir die Spalten Rel Start und Duration, ob sich mehrere Verbindungen zeitlich überlappen oder sauber nacheinander laufen. Und innerhalb einer Verbindung zeigt dir Statistics → Flow Graph (mit der Option, nur die gefilterten Pakete anzuzeigen) das typische Ping-Pong: Pfeil hin, Pfeil zurück, Pfeil hin – nie zwei Requests ohne Antwort dazwischen. Noch plakativer wird es im Statistics → TCP Stream Graphs → Stevens: Statt einer steil ansteigenden Linie wie bei einem Datentransfer siehst du eine Treppe aus vielen kleinen Stufen, jede Stufe ungefähr eine RTT breit.
Für die genaue Zuordnung der Segmente zu den einzelnen Transaktionen ist die TCP-Stream-Analyse in Wireshark das grundlegende Handwerkszeug – dort zeige ich ausführlich, wie du logische Anfragen innerhalb einer Verbindung auseinanderhältst.
Niedrige Bandbreitenauslastung trotz „gefühlter“ Langsamkeit
Das zweite auffällige Merkmal ist der Widerspruch zwischen gefühlter Performance und tatsächlicher Auslastung. Im Statistics → I/O Graph (Y-Achse auf Bits/s umstellen, Standard sind Pakete pro Sekunde) siehst du bei einem Serialisierungsproblem fast immer eine sehr bescheidene Kurve – oft im niedrigen einstelligen Prozentbereich der verfügbaren Bandbreite. Die Leitung ist zu keinem Zeitpunkt das Nadelöhr. Trotzdem dauert der Gesamtvorgang quälend lange.
Diesen Punkt betone ich in Kundengesprächen immer wieder: Eine langsame Anwendung ist nicht automatisch ein Bandbreitenproblem. Wenn die Leitung nie auch nur annähernd voll ist, kann auch eine 10-Gbit-Anbindung das Problem nicht lösen. Die Anwendung erzeugt die Daten schlicht nicht schnell genug, um die vorhandene Bandbreite überhaupt zu nutzen – sie wartet die meiste Zeit auf Antworten.
Die Zeit pro Turn zerlegen: Netzwerk, Server, Client
Das für mich aussagekräftigste Werkzeug ist die Zerlegung eines einzelnen Turns in seine drei Bestandteile. Jeder Request-Response-Zyklus besteht aus der Netzwerklaufzeit (RTT), der Verarbeitungszeit auf dem Server und der Pause auf dem Client, bevor er den nächsten Request schickt. Wenn du diese drei Werte kennst, ist die Schuldfrage beantwortet – und zwar mit Zahlen statt Meinungen.
Wireshark liefert dir dafür alles, was du brauchst. Damit das Feld tcp.time_delta gefüllt wird, aktivierst du einmalig unter Edit → Preferences → Protocols → TCP die Option Calculate conversation timestamps. Danach legst du die folgenden Felder als Spalten an:
| Messgröße | Wireshark-Feld | Was es dir sagt |
|---|---|---|
| Basis-RTT | tcp.analysis.initial_rtt |
Die Laufzeit aus dem TCP-Handshake – deine Referenz dafür, was die Strecke physikalisch leistet. |
| Laufende RTT | tcp.analysis.ack_rtt |
Wie schnell Segmente bestätigt werden. Steigt bei Überlast und Queueing deutlich über die Basis-RTT. |
| Antwortzeit pro Request | http.time |
Zeit vom Request bis zur Response, am Client gemessen: RTT plus Verarbeitungszeit des Servers. |
| Client-Pause | tcp.time_delta |
Zeit seit dem vorherigen Paket im selben Stream. In den Zeilen mit einem Request zeigt sie, wie lange der Client vor dem nächsten Request gewartet hat. |
| Netzwerkfehler | tcp.analysis.flags |
Retransmissions, Duplicate ACKs, Zero Windows. Bei reiner serieller Verarbeitung praktisch leer. |
Mit dem folgenden Filter blendest du nur noch die Requests und Responses der Verbindung ein und kannst die Spalten Zeile für Zeile ablesen. tcp.time_delta bezieht sich dabei immer auf das vorherige Paket im Stream, nicht auf das vorherige angezeigte Paket – der Display-Filter verfälscht den Wert also nicht:
tcp.stream eq 0 and (http.request or http.response)
Die Serverzeit ergibt sich näherungsweise aus http.time minus Basis-RTT. Hast du zusätzlich einen Trace auf dem Server, kannst du sie dort direkt ablesen. Und die Gegenprobe auf Netzwerkfehler machst du mit diesem Filter, der die harmlosen Window-Updates ausblendet:
tcp.analysis.flags && !tcp.analysis.window_update
Das Bild, das sich dann ergibt, ist meist eindeutig: Bei einem echten Netzwerkproblem liegt die laufende RTT deutlich über der Basis-RTT, schwankt stark oder es tauchen Retransmissions auf. Bei einem Serialisierungsproblem dagegen entspricht jeder Turn ziemlich exakt der Basis-RTT plus ein paar Millisekunden Serverzeit – sauber, gleichmäßig, unspektakulär. Nur eben hunderte Male hintereinander.
Und wenn alles verschlüsselt ist?
In der Praxis läuft der Großteil des Anwendungsverkehrs heute über TLS, und dann siehst du keine HTTP-Requests im Klartext. Das Muster bleibt trotzdem erkennbar: Die Nutzdaten stecken in TLS-Records vom Typ Application Data, und an Richtung, Größe und Timing dieser Records erkennst du das Ping-Pong genauso gut. Ein kleiner Record vom Client, eine Antwort vom Server, wieder ein kleiner Record vom Client:
tcp.stream eq 0 and tls.record.content_type == 23
Wenn du den Client kontrollierst, kannst du für eine Messung zusätzlich die TLS-Sitzungsschlüssel über die Umgebungsvariable SSLKEYLOGFILE mitschreiben lassen und in Wireshark hinterlegen. Dann stehen dir auch http.time und die übrigen HTTP-Felder wieder zur Verfügung. Für den reinen Nachweis des seriellen Musters ist das aber meist gar nicht nötig.
Single-Threading vs. echtes Netzwerkproblem – die Unterscheidungsmerkmale
Damit du das schnell einordnen kannst, hier die Symptome im direkten Vergleich – so, wie ich sie auch in Analyseberichten für Kunden gegenüberstelle:
| Merkmal im Trace | Echtes Netzwerkproblem (Überlast, Paketverlust, Fehler) | Serielle Verarbeitung / Single-Threading |
|---|---|---|
| RTT pro Turn | Deutlich über der Basis-RTT, oft stark schwankend (Queueing) | Entspricht der Basis-RTT, sehr gleichmäßig |
| Retransmissions / Duplicate ACKs | Häufig sichtbar, oft gehäuft | Praktisch nicht vorhanden, saubere ACK-Folgen |
| Bandbreitenauslastung | Bei Überlast phasenweise am Limit | Durchgehend niedrig, Leitung nie ausgelastet |
| Überlappung von Requests | Vorhanden – die Anwendung parallelisiert normal, wird aber ausgebremst | Keine – neuer Request erst nach vollständiger Response |
| Pause vor dem nächsten Request | Nahe null – der Client würde sofort weitermachen | Chatty: klein, aber hunderte Turns. Rechenlastig: deutlich messbar |
| Gesamtzeit wächst mit | Datenmenge und Verlustrate | Anzahl der Turns × RTT |
| Standort mit höherer RTT | Kein fester Zusammenhang zur RTT-Differenz | Mehrzeit ≈ Anzahl Turns × RTT-Differenz |
| Was hilft | Ursache im Netz beheben: Überlast, Duplex-Mismatch, defekte Strecke, QoS | Weniger Turns: Batching, Parallelisierung, Connection Pooling |
Wenn du in einem Trace Retransmissions findest, lohnt sich ein genauer Blick, was sie wirklich bedeuten – den Unterschied zwischen Retransmissions, Duplicate ACKs und Out-of-Order habe ich in einem eigenen Artikel aufgeschlüsselt.
In der Praxis ist die Skalierung oft das schlagendste Argument, weil sie sich sauber demonstrieren lässt. Die entscheidende Frage lautet: Wächst die Ladezeit mit der Datenmenge oder mit der Anzahl der Turns? Verdoppelt sich die Anzahl der geladenen Datensätze und mit ihr fast exakt die Ladezeit – obwohl jeder Datensatz nur ein paar hundert Byte groß ist –, dann bezahlst du pro Datensatz einen Round Trip. Ein Bandbreitenproblem würde dagegen mit den übertragenen Bytes skalieren, und die sind in so einem Fall winzig.
Noch eindeutiger wird es mit einem Standortvergleich: Miss denselben Vorgang einmal im LAN direkt neben dem Server und einmal am entfernten Standort. Ist die Differenz der Ladezeiten ungefähr so groß wie die Anzahl der Turns mal die RTT-Differenz, ist der Fall erklärt:
Mehrzeit am Standort ≈ Anzahl Turns × (RTT Standort − RTT LAN)
Warum RTT (Latenz) hier zum Multiplikator wird
Um zu verstehen, warum serielle Verarbeitung gerade über WAN-Verbindungen so schmerzhaft wird, lohnt sich ein Blick auf die Grundrechenart dahinter. Mehr Hintergrund zur Round Trip Time und ihrer Analyse findest du in einem eigenen Artikel – hier nur das Wesentliche für unseren Fall.
Bei paralleler Verarbeitung „versteckt“ sich die Latenz: Während Request A auf seine Antwort wartet, sind Request B und C bereits unterwegs. Die Wartezeiten überlappen sich, und die Gesamtzeit für viele Requests liegt bei guter Parallelisierung nur bei einem Bruchteil der Summe aller Einzelzeiten.
Bei serieller Verarbeitung passiert das Gegenteil: Jeder Request muss vollständig abgeschlossen sein, bevor der nächste überhaupt beginnt. Die Latenz wird nicht versteckt, sondern addiert sich Turn für Turn auf. Als Faustformel gilt:
Gesamtzeit ≈ Anzahl Turns × (RTT + Serverzeit + Client-Pause)
Bei einer chatty Anwendung sind Server- und Client-Anteil klein, und die Formel schrumpft praktisch auf Anzahl Turns × RTT. Bei einer RTT von 40 ms und 300 Einzel-Requests kommst du so auf rund 12 Sekunden reine Wartezeit – ohne dass ein einziges Paket verloren geht oder die Bandbreite auch nur ansatzweise ausgereizt wird. Dieselben 300 Requests im LAN mit einer RTT von 1 ms? Gerade einmal 0,3 Sekunden.
Genau deshalb sehen diese Fälle im LAN harmlos aus und werden erst über WAN-Strecken, VPN-Tunnel oder Cloud-Anbindungen zum echten Problem. Typischer Auslöser ist eine Serverkonsolidierung ins zentrale Rechenzentrum oder die Migration in die Cloud. Die Anwendung hat sich nicht verändert – nur die Umgebung, in der ihre serielle Kommunikation plötzlich ins Gewicht fällt. Und genau deshalb ist auch der Satz der Entwicklung „der Code hat sich nicht geändert“ völlig korrekt – und trotzdem kein Argument gegen eine Ursache in der Anwendung.
Praxisfall: Der Trace im Detail
Ein typisches, anonymisiertes Beispiel aus einem Projekt: Eine Fachanwendung war im Zuge einer Konsolidierung ins zentrale Rechenzentrum umgezogen. Am angebundenen Standort dauerte das Laden einer Übersichtsliste seitdem zwischen 10 und 11 Sekunden – eine Liste, die vorher mit dem Server im selben Gebäude in unter zwei Sekunden aufgebaut war. Die Basis-RTT zwischen Standort und Rechenzentrum lag bei 35 ms, für eine WAN-Strecke ein völlig unauffälliger Wert.
Der Trace zeigte im Filter auf den betroffenen Stream ein sehr klares Bild: Statt weniger großer Requests fand ich über 250 einzelne HTTP-Requests über eine einzige, dauerhaft offene Verbindung, jeder für sich winzig – meist wenige hundert Byte Payload. Der Handshake fand nur einmal statt und dauerte genau eine RTT. Danach: striktes Ping-Pong. Nie war mehr als ein Request gleichzeitig offen, im Stevens-Graph die typische Treppe aus gleichmäßigen Stufen.
Die Zerlegung eines Turns ergab dann folgendes Bild:
- Antwortzeit (
http.time): im Mittel rund 38 bis 39 ms – davon 35 ms reine Netzwerklaufzeit und nur etwa 3 bis 4 ms Verarbeitungszeit auf dem Server. - Client-Pause (
tcp.time_deltavor jedem Request): rund 1 ms. Der Client schickte den nächsten Request also praktisch sofort hinterher. - Netzwerkfehler: keine Retransmissions, keine Duplicate ACKs, laufende RTT stabil auf Höhe der Basis-RTT.
- Auslastung: unter 2 % der verfügbaren Bandbreite – ein Wert, der jedes „Das Netzwerk ist zu langsam“ von Anfang an entkräftet hätte, wäre er früher betrachtet worden.
Damit war die Rechnung schnell aufgemacht: 250 Turns × rund 40 ms ergeben etwa 10 Sekunden – nahezu die komplette gemessene Ladezeit. Allein die reine Laufzeit von 250 × 35 ms macht davon knapp 9 Sekunden aus. Zum Vergleich die alte Situation im selben Gebäude: 250 Turns × rund 5 ms ergeben gut eine Sekunde. Das Netzwerk lieferte also exakt die 35 ms, die die Strecke physikalisch hergibt – die Anwendung fragte nur 250-mal hintereinander danach.
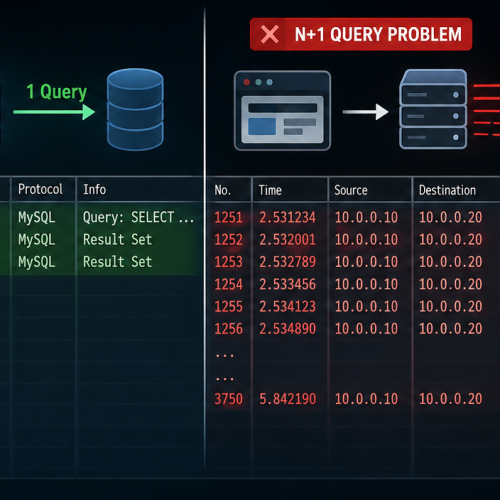
Die Anwendung lud die Liste offensichtlich Datensatz für Datensatz nach, statt die Daten in einem oder wenigen Requests gebündelt abzuholen. Das Muster ist fast identisch zu dem, was ich im Praxisfall zu sequentiellen DB-Requests und N+1 Queries beschrieben habe – nur eine Ebene höher, auf der Anwendungs- statt der Datenbankschicht. Wie sich dasselbe Prinzip bei SQL-Zugriffen über eine WAN-Strecke auswirkt, zeigt der Praxisfall SQL über WAN-Strecke.
Die Lösung: Batching, Parallelisierung, Connection Pooling
Ist die Ursache erst einmal sauber belegt, ist die technische Lösung meist gar nicht kompliziert – sie liegt nur eben nicht im Netzwerk, sondern im Anwendungsdesign. In der Praxis kommen typischerweise drei Ansätze zum Einsatz, oft in Kombination:
- Batching: Der wirksamste Hebel ist oft der einfachste. Statt 250 Einzel-Requests für 250 Datensätze werden die Daten in einem oder wenigen gebündelten Requests abgeholt. Aus 250 Turns werden dann im besten Fall eine Handvoll – die etwas größere Antwort braucht durch den TCP Slow Start zwar ein paar RTT mehr, aber eben ein paar, nicht 250. Im Praxisfall hätte das die Ladezeit rechnerisch von gut 10 Sekunden auf deutlich unter eine Sekunde gedrückt.
- Parallelisierung: Statt Requests strikt nacheinander abzusetzen, werden mehrere gleichzeitig verschickt – über asynchrone Aufrufe, mehrere Verbindungen oder HTTP/2-Multiplexing. Schon eine moderate Parallelität von vier bis acht gleichzeitigen Requests kann die Gesamtzeit drastisch senken, weil sich die Latenzen dann überlappen statt zu addieren.
- Connection Pooling: Wird für jeden Request eine neue TCP-Verbindung aufgebaut, kostet allein der TCP-Handshake jedes Mal eine zusätzliche RTT. Mit TLS kommt der Verschlüsselungs-Handshake dazu – bei TLS 1.3 eine weitere RTT, bei TLS 1.2 zwei. Ein Pool wiederverwendbarer, bereits offener Verbindungen spart diesen Overhead bei jedem einzelnen Request.
Welcher Ansatz sinnvoll ist, hängt stark von der Architektur ab – klassische Web-Anwendung, API-Integration oder Legacy-Applikation, an deren Code niemand mehr herankommt. Für den letzten Fall gibt es einen pragmatischen Ausweg: Die Anwendung selbst ins Rechenzentrum holen. Läuft der Client auf einem Terminalserver oder in einer VDI direkt neben dem Server, finden die 250 Turns wieder im LAN statt, und über das WAN geht nur noch die Bildschirmausgabe. Klassische WAN-Optimierer helfen dagegen bei latenzgebundenen, seriellen Mustern meist wenig, denn an der Physik der Strecke ändern sie nichts.
Entscheidend aus Analyse-Sicht ist ohnehin nicht die konkrete Umsetzung, sondern der Nachweis, dass genau hier – und nicht in der Leitung – der Hebel für die Verbesserung liegt.
Was das für Netzwerk-, Applikationsteams und IT-Leitung bedeutet
An dieser Stelle schließt sich der Kreis zu dem, was ich in Projekten als „Forensik statt Fingerpointing“ bezeichne. Das Netzwerkteam hatte in unserem Beispiel recht: keine Paketverluste, keine Congestion, keine erhöhte RTT. Die Entwicklung hatte ebenfalls recht: Der Code hatte sich nicht verändert. Was fehlte, war der objektive Blick auf das Zusammenspiel beider Seiten – und der lässt sich nur mit einem sauberen, korrekt interpretierten Paket-Trace liefern.
Für Netzwerkteams bedeutet das: Ein Trace mit niedriger Auslastung, stabiler RTT und sauberen ACK-Folgen ist kein Freibrief zum Zurücklehnen, sondern der entscheidende Beweis, dass die Ursache anderswo liegt – und genau dieser Beweis nimmt dich aus der Schusslinie.
Für Entwickler- und Applikationsteams bedeutet es umgekehrt: Ein Trace mit exakt getakteten, seriellen Turns ist keine Anschuldigung, sondern eine sehr konkrete, messbare Grundlage. Du weißt danach genau, wie viele Round Trips ein Vorgang kostet und wie viel ihr durch Batching oder Parallelisierung einsparen könnt – oft mit überschaubarem Aufwand und großer Wirkung.
Für IT-Leiter und Entscheider ist die wichtigste Erkenntnis eine wirtschaftliche: Mehr Bandbreite, eine teurere Leitung oder neue Hardware hätten in diesem Fall keine einzige Sekunde gebracht. Eine Analyse, die die Zeit sauber auf Netzwerk, Server und Client aufteilt, verhindert genau solche Fehlinvestitionen – und beendet Diskussionen, die sonst Wochen dauern und Teams gegeneinander aufbringen.
Wenn du dir grundsätzlich eine strukturierte Vorgehensweise für solche Fälle zurechtlegen willst, findest du in der 5-Schritte-Methodik zur systematischen Eingrenzung von Netzwerkproblemen den passenden Rahmen. Und der Artikel „Warum ist mein Netzwerk langsam trotz 1 Gbit?“ beschreibt die grundlegende Herangehensweise an genau solche Performance-Rätsel.
Fazit
Nicht jede langsame Anwendung hat ein Netzwerkproblem – und nicht jedes Fingerpointing zwischen Netzwerk- und Applikationsteam lässt sich ohne belastbare Daten auflösen. Serielle Verarbeitung hinterlässt im Wireshark-Trace ein sehr charakteristisches Muster: viele kleine, streng nacheinander ablaufende Request-Response-Zyklen, keine Überlappung, eine durchgehend niedrige Bandbreitenauslastung und eine RTT, die sauber auf dem Niveau der Basis-Latenz liegt. Die Gesamtzeit ergibt sich dann fast vollständig aus Anzahl Turns × RTT.
Wer dieses Muster einmal erkannt hat und die Zeit eines Turns in Netzwerk, Server und Client zerlegen kann, weiß nach wenigen Minuten, ob es sich lohnt, weiter am Netzwerk zu drehen – oder ob der eigentliche Hebel im Kommunikationsverhalten der Anwendung liegt. Und genau dieser Unterschied entscheidet oft darüber, ob ein Performance-Problem in Stunden oder in Wochen gelöst wird.
Du steckst gerade selbst in so einer Diskussion?
Egal ob du im Netzwerkteam sitzt, eine Anwendung verantwortest oder als IT-Leiter zwischen beiden Seiten vermitteln musst: Wenn bei euch gerade die Frage „Netz oder Anwendung?“ im Raum steht, lass uns darüber sprechen. Im kostenlosen Erstgespräch schauen wir uns gemeinsam die Situation an und klären, ob und wie eine Paketanalyse die Ursache sichtbar machen kann. Hier geht es zum Kontaktformular. Wie ich bei solchen Analysen vorgehe, findest du auch in der Übersicht meiner Leistungen.