TCP Retransmissions analysieren & beheben mit Wireshark
„Das Netzwerk ist langsam.“ Wenn dieser Satz in der IT-Abteilung fällt, bricht bei vielen Administratoren erst einmal leichter Stress aus. Die Monitoring-Tools zeigen grünes Licht: Die CPU-Last der Server ist im Keller, der RAM ist ausreichend dimensioniert und die Bandbreite der Uplinks ist bei weitem nicht ausgeschöpft. Und doch beschweren sich die Anwender über zähe Datenbankabfragen, abbrechende Dateiübertragungen oder ruckelnde Video-Calls.
In meiner jahrelangen Praxis als Netzwerkanalyst habe ich gelernt: Wenn die Metriken an der Oberfläche gut aussehen, das Nutzererlebnis aber katastrophal ist, lohnt sich fast immer ein tiefer Blick in den TCP-Stack. Sehr oft stoßen wir dort auf ein Phänomen, das wie kaum ein anderes die Effizienz digitaler Prozesse untergräbt: TCP Retransmissions.
In diesem Artikel zeige ich dir, warum Retransmissions entstehen, warum schon wenig Paketverlust deine Anwendungen massiv ausbremst, wie du sie mit Wireshark sauber nachweist – und wie du herausfindest, wo im Netz die Pakete tatsächlich verloren gehen.
Das typische Szenario: Wenn „genug Bandbreite“ nicht mehr hilft
Stell dir ein mittelständisches Unternehmen vor. Die Zentrale ist über eine dedizierte 1-Gbit/s-Leitung mit dem Rechenzentrum verbunden. Eigentlich genug Kapazität für alle Workloads. Doch seit der Einführung eines neuen ERP-Systems klagen die Außenstellen über massive Latenzen.
Der Standardreflex vieler IT-Abteilungen: „Wir brauchen mehr Bandbreite.“ Doch oft ist das ein teurer Trugschluss. In einem Projekt, das ich vor Kurzem betreut habe, lag die Auslastung der Leitung bei gerade einmal 20 %. Trotzdem fühlte sich die Anwendung an wie zu ISDN-Zeiten.
Die Ursache war nicht mangelnder Durchsatz, sondern eine instabile Strecke, die zu Paketverlusten führte. Und genau hier greift der Korrekturmechanismus von TCP ein: die Retransmission. Das Problem dabei: TCP interpretiert verlorene Pakete standardmäßig als Zeichen für Überlast. Sobald Daten verloren gehen, drosselt es die Senderate deutlich – auch dann, wenn die Leitung eigentlich frei ist und der Verlust durch ein defektes Bauteil entsteht. Wir haben es also mit einem klassischen Bottleneck zu tun, das nicht durch die Leitungskapazität, sondern durch die Fehlerkorrektur des Protokolls entsteht. Wie drastisch das wirkt, rechne ich dir weiter unten an einem Beispiel vor.
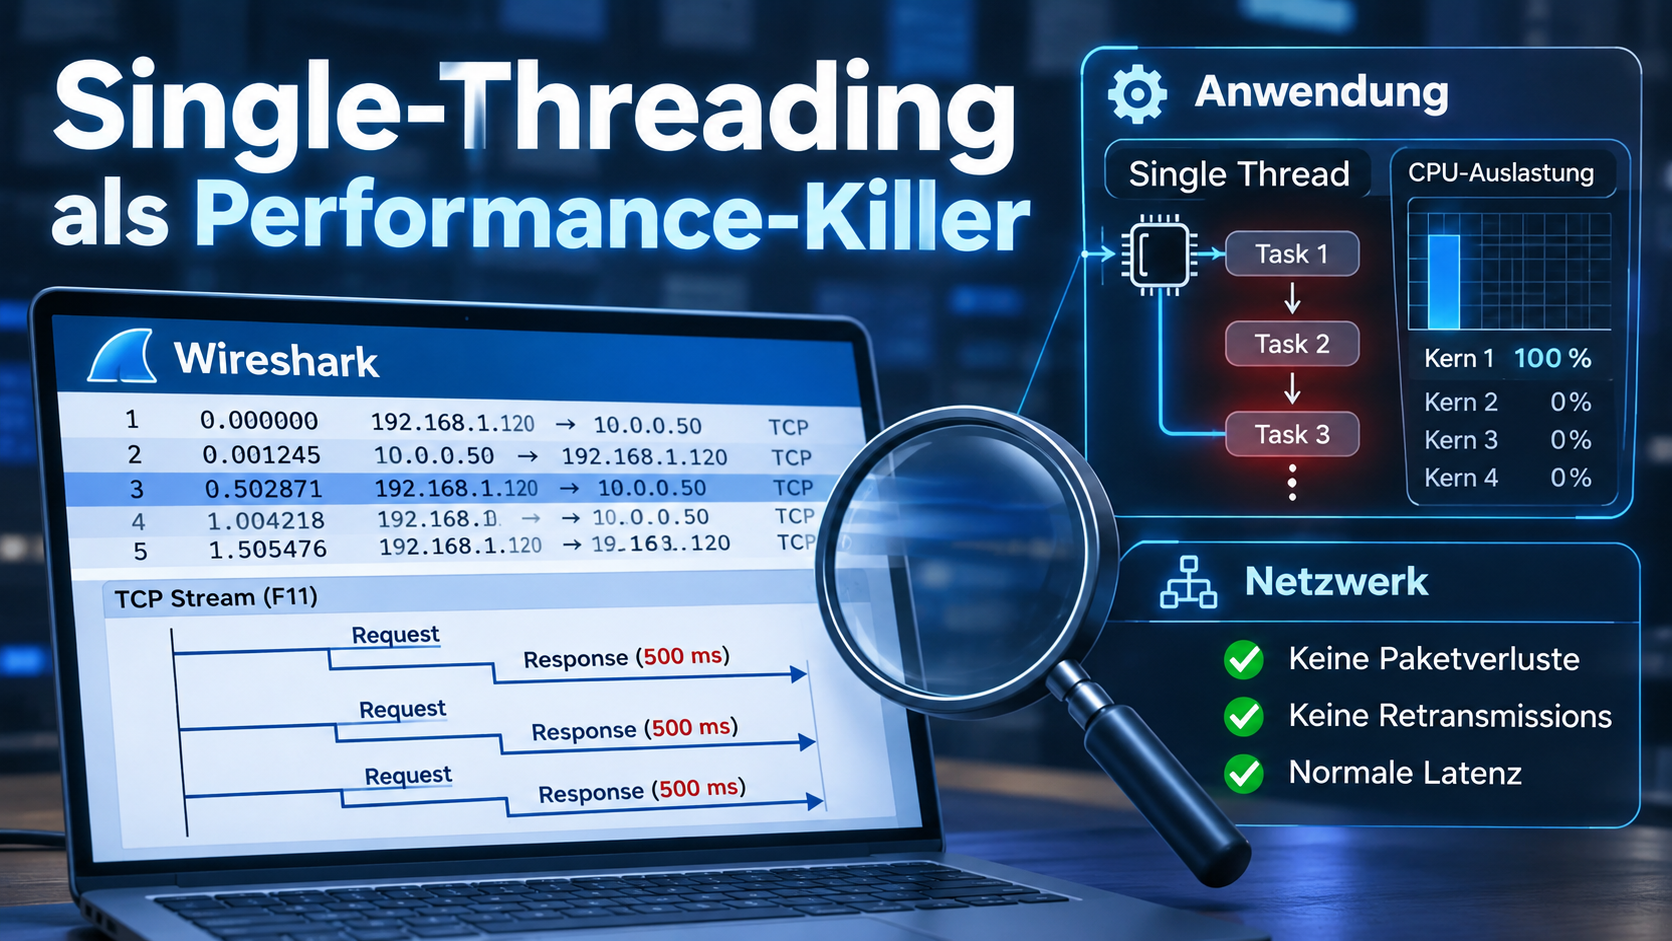
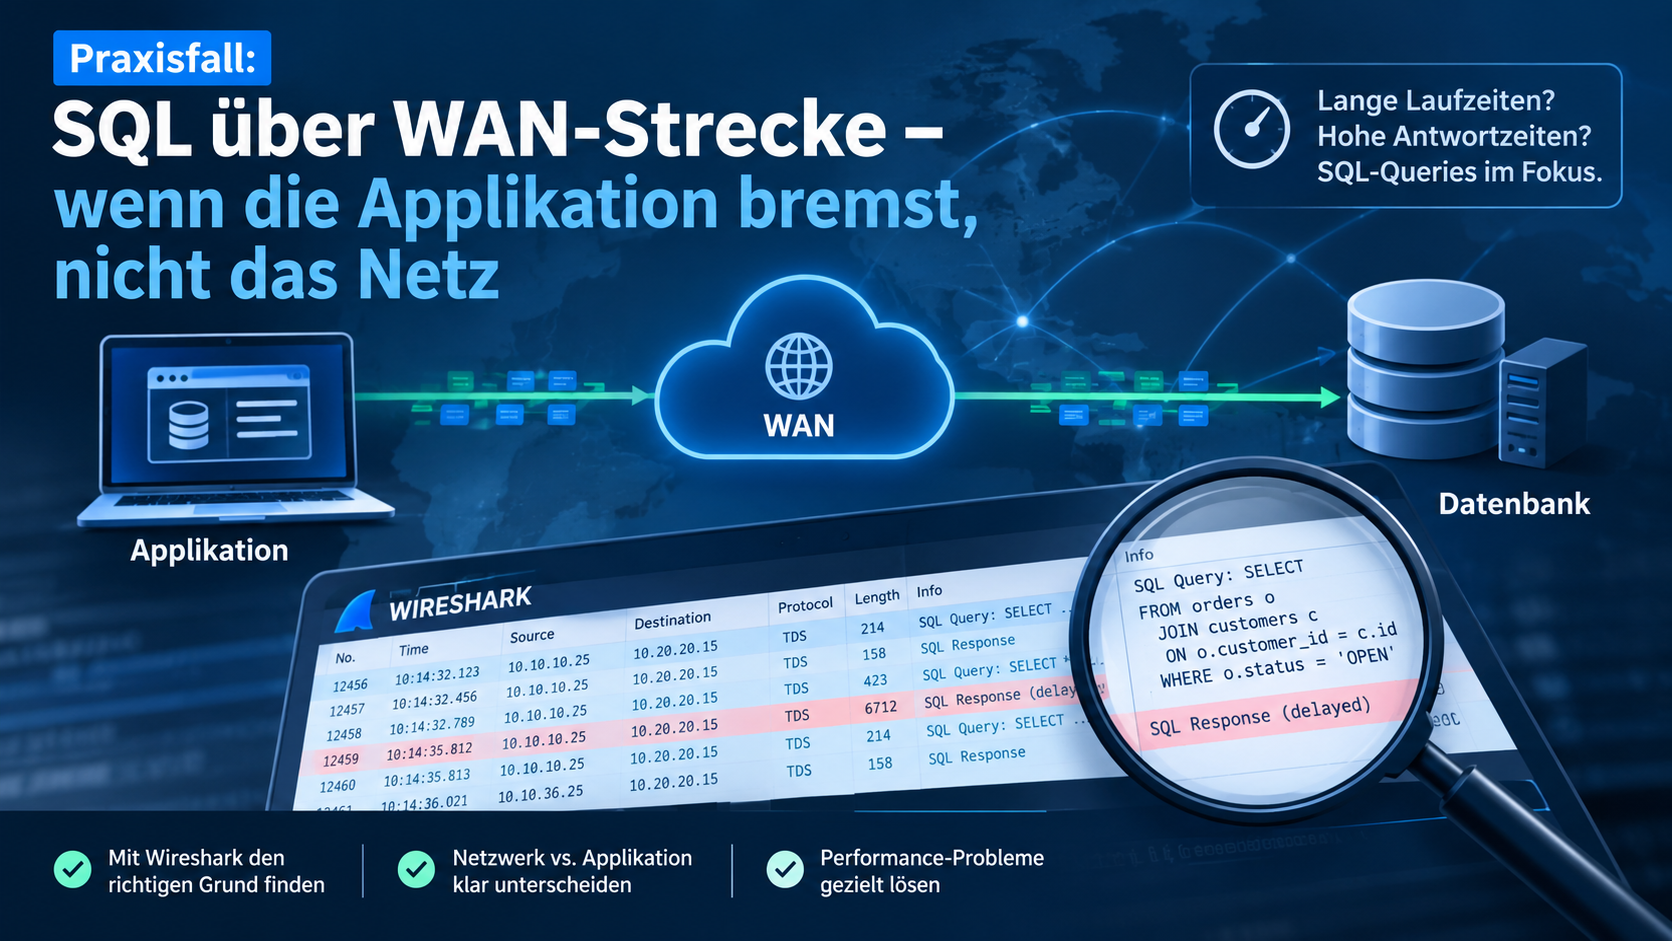
Fairerweise gilt auch die Gegenrichtung: Nicht jede langsame Anwendung über WAN hat ein Netzwerkproblem. Manchmal bremst die Applikation selbst, etwa durch tausende kleine Abfragen hintereinander. Ein Beispiel dafür findest du in meinem Praxisfall: SQL über WAN-Strecke. Genau deshalb lohnt es sich, Retransmissions sauber nachzuweisen, statt sie zu vermuten.
Technischer Hintergrund: Warum gibt es TCP Retransmissions?
Um zu verstehen, wie wir das Problem lösen, müssen wir kurz die Mechanik von TCP (Transmission Control Protocol) betrachten. TCP ist ein verbindungsorientiertes Protokoll, das sicherstellt, dass Daten vollständig und in der richtigen Reihenfolge ankommen.
Das Prinzip der Bestätigung (ACK)
Der Empfänger bestätigt erhaltene Daten mit einem Acknowledgement (ACK). Genau genommen bestätigt er nicht jedes Paket einzeln, sondern kumulativ: „Ich habe alles bis Sequenznummer X erhalten, schick mir als Nächstes X.“ Fehlt ein Paket, kann er nur bis zur Lücke bestätigen. Genau daraus ergeben sich die zwei Wege, auf denen eine Retransmission ausgelöst wird.
Zwei Wege zur Retransmission: Fast Retransmit und Timeout
| Mechanismus | Auslöser | Wartezeit | Reaktion von TCP |
|---|---|---|---|
| Fast Retransmission | Der Sender erhält drei Duplicate ACKs („mir fehlt immer noch X“) | ca. eine Round Trip Time (RTT) | Congestion Window wird reduziert (Reno: halbiert, CUBIC: auf ca. 70 %), die Übertragung läuft weiter |
| Timeout-Retransmission (RTO) | Innerhalb des Retransmission Timeouts kommt gar kein passendes ACK | mindestens ca. 200 ms (Linux) bzw. 300 ms (Windows), beim Verbindungsaufbau 1 s | Congestion Window fällt auf ein einziges Segment, TCP startet mit Slow Start praktisch von vorn |
Die Fast Retransmission ist die „günstige“ Variante: Der Verlust wird schnell erkannt, der Durchsatz sinkt, aber die Verbindung läuft weiter. Die Timeout-Retransmission ist für Anwender deutlich schmerzhafter. Hier steht die Übertragung für hunderte Millisekunden komplett still. Geht auch die Wiederholung verloren, verdoppelt TCP den Timeout bei jedem weiteren Versuch (Exponential Backoff): 300 ms, 600 ms, 1,2 s, 2,4 s … Genau dieses Muster erklärt, warum Anwendungen bei Paketverlust nicht nur langsam werden, sondern regelrecht „einfrieren“ – und warum Sitzungen irgendwann ganz abbrechen. Mehr dazu findest du in meinem Artikel zum Thema Verbindungsabbrüche analysieren mit Wireshark.
Warum gerade ERP- und Datenbank-Anwendungen so leiden: Eine Fast Retransmission braucht nachfolgende Pakete, die beim Empfänger die Duplicate ACKs auslösen. Ist eine Antwort aber nur ein oder zwei Pakete groß – oder geht das letzte Segment einer Übertragung verloren –, kommen keine Duplicate ACKs zustande. Dann bleibt nur der Timeout. Bei Anwendungen mit vielen kleinen Anfragen bedeutet das: Jede betroffene Abfrage wartet mindestens 200–300 ms extra. Moderne Linux- und Windows-Versionen mildern das mit Verfahren wie Tail Loss Probe (TLP) und RACK, die Verluste auch zeitbasiert erkennen. Abschaffen können sie das Problem aber nicht.
Wie Duplicate ACKs, Retransmissions und Out-of-Order-Pakete im Detail zusammenhängen, habe ich separat erklärt: TCP Retransmissions, Dup ACKs & Out-of-Order – was die Unterschiede wirklich bedeuten.
Wie stark bremst Paketverlust wirklich?
Für klassische, verlustbasierte TCP-Algorithmen gibt es eine bekannte Faustformel, die sogenannte Mathis-Formel. Sie schätzt den maximalen Durchsatz einer einzelnen TCP-Verbindung bei gegebenem Paketverlust ab:
Max. Durchsatz ≈ (MSS / RTT) × (1,22 / √Paketverlustrate)
Ein Rechenbeispiel mit typischen Werten für eine Standortanbindung: MSS 1.460 Byte, RTT 20 ms, 1 % Paketverlust. Ergebnis: rund 7 Mbit/s pro TCP-Verbindung – auf einer 1-Gbit/s-Leitung. Selbst bei nur 0,1 % Verlust landest du bei etwa 22 Mbit/s. Im LAN mit 1 ms RTT wäre derselbe Verlust zwanzigmal weniger dramatisch. Das zeigt zwei Dinge: Paketverlust und Latenz verstärken sich gegenseitig, und mehr Bandbreite ändert an dieser Rechnung gar nichts. Wie du die RTT einer Strecke sauber bestimmst, zeige ich unter Hohe Latenz im Firmennetz – RTT analysieren.
Wichtig: Die Formel ist ein Modell für Reno-artiges Verhalten. Moderne Algorithmen wie CUBIC oder BBR reagieren anders auf Verlust, BBR sogar deutlich toleranter. Die Größenordnung des Problems bleibt in der Praxis aber oft erstaunlich ähnlich. Einen Vergleich der Algorithmen findest du unter Congestion Control – Reno, CUBIC und BBR im Vergleich. Und denk daran, dass auch das TCP Window den Durchsatz begrenzt – das ist eine zweite, unabhängige Bremse.
Analyse mit Wireshark: Den Fehlern auf der Spur
Wireshark ist für uns Netzwerkanalysten das Skalpell. Ohne einen Paketmitschnitt (Trace) raten wir nur – mit Wireshark wissen wir genau, was auf dem Draht passiert.
1. Den Trace richtig aufnehmen
Bevor wir analysieren, müssen wir die Daten sauber erfassen. Ein Trace direkt auf dem Client oder Server ist oft der erste Schritt. Wenn du jedoch Infrastrukturkomponenten wie Firewalls oder Switches im Verdacht hast, ist ein Mirror-Port (SPAN) oder ein Netzwerk-TAP am entsprechenden Hop unumgänglich.
Drei Punkte werden dabei oft übersehen:
- Miss möglichst an beiden Enden gleichzeitig. Nur so kannst du später belegen, auf welchem Abschnitt die Pakete verloren gehen (siehe Schritt 5). Einzelne Pakete ordnest du zwischen den Traces am zuverlässigsten über Sequenznummer und IP-ID zu, nicht über die Uhrzeit.
- Der Mitschnitt selbst kann lügen. Ein überlasteter SPAN-Port – etwa beide Richtungen eines ausgelasteten 1-Gbit-Ports auf einem einzigen 1-Gbit-Mirror – oder ein zu langsamer Messrechner verwirft Pakete. Dann sieht Wireshark Lücken, die es auf der Leitung nie gab. Ein typischer Hinweis sind viele Meldungen wie „ACKed unseen segment“. Ob der Messrechner selbst Pakete verloren hat, zeigt dir Statistics → Capture File Properties in der Angabe „Dropped packets“.
- Offloading verfälscht das Bild am Endgerät. Misst du direkt auf Client oder Server, sorgen TSO und GRO der Netzwerkkarte dafür, dass Wireshark Pakete weit über 1.514 Byte und falsche Checksummen anzeigt. Das ist kein Leitungsfehler, sondern ein Effekt der Karte. Außerdem siehst du dort Pakete, bevor die Karte sie sendet – verwirft sie selbst etwas, bleibt das im Trace unsichtbar.
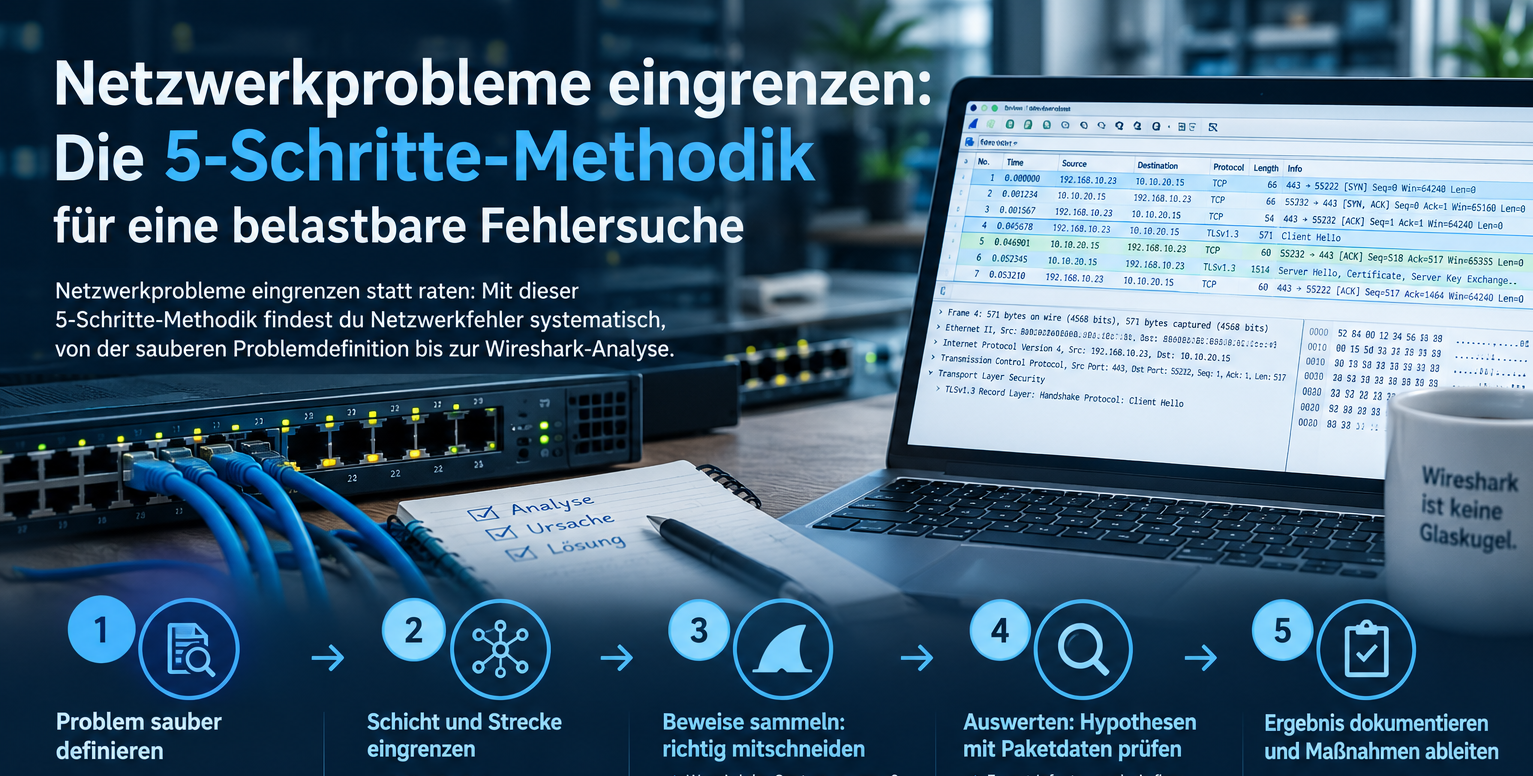
Wie du eine Messung von Anfang an strukturiert planst, beschreibe ich in meiner 5-Schritte-Methodik zur Eingrenzung von Netzwerkproblemen.
2. Der entscheidende Filter
Öffne Wireshark und lade deinen Trace. Die Flut an Paketen kann erschlagend wirken. Nutze daher den eingebauten Analyse-Filter für Retransmissions:
tcp.analysis.retransmission
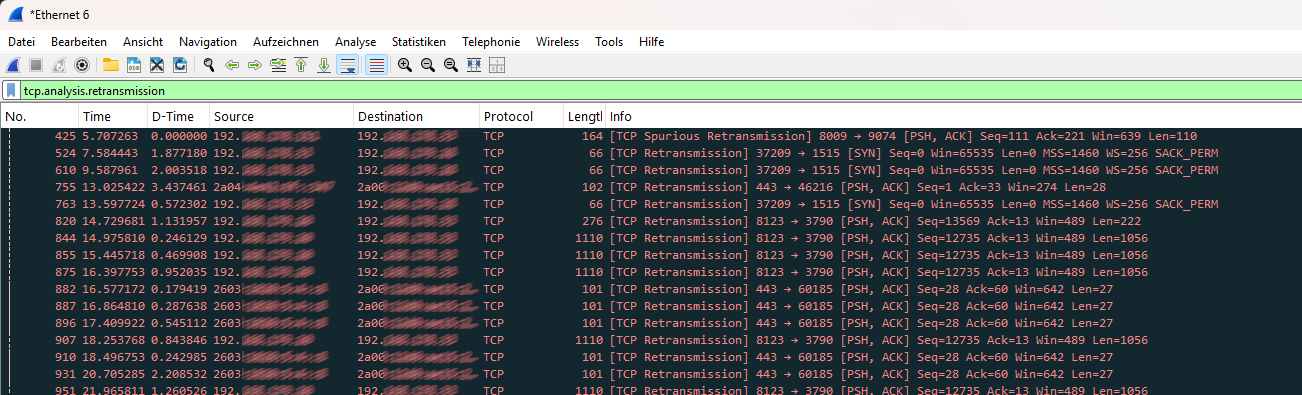
Gib diesen Ausdruck in die Filterzeile ein. Die gefundenen Pakete erscheinen im Standard-Farbschema schwarz mit roter Schrift („Bad TCP“). Der Filter erfasst dabei auch Fast und Spurious Retransmissions. Aber Vorsicht: Ein paar Retransmissions beweisen noch kein Problem. Entscheidend ist das Verhältnis zur Gesamtmenge. Wireshark zeigt dir in der Statusleiste unten, wie viele Pakete der Filter anzeigt. Vergleiche diesen Wert mit der Anzahl der Datenpakete derselben Verbindung (Filter tcp.len > 0), nicht mit allen TCP-Paketen. Reine ACKs ohne Nutzdaten verwässern sonst die Quote. Und schau dir die betroffene Verbindung einzeln an, nicht den gesamten Trace.
Für die Feinanalyse helfen dir diese Filter weiter:
| Filter | Was er zeigt |
|---|---|
tcp.analysis.retransmission |
Alle erkannten Retransmissions |
tcp.analysis.fast_retransmission |
Retransmissions, die durch Duplicate ACKs ausgelöst wurden |
tcp.analysis.spurious_retransmission |
Unnötige Wiederholungen – das Original war bereits angekommen |
tcp.analysis.duplicate_ack |
Der Empfänger meldet eine Lücke im Datenstrom |
tcp.analysis.lost_segment |
Lücke im Mitschnitt („Previous segment not captured“) |
tcp.analysis.ack_lost_segment |
ACK für ein Segment, das nie mitgeschnitten wurde – oft ein Messartefakt |
tcp.analysis.rto >= 0.2 |
Retransmissions, die erst mehr als 200 ms nach dem Original kamen – typisch für Timeouts |
tcp.analysis.flags |
Alle TCP-Auffälligkeiten auf einen Blick |
Weitere Filter für den Alltag findest du in meinem Guide Wireshark – Die 10 wichtigsten Display-Filter.
3. Die Experten-Analyse nutzen
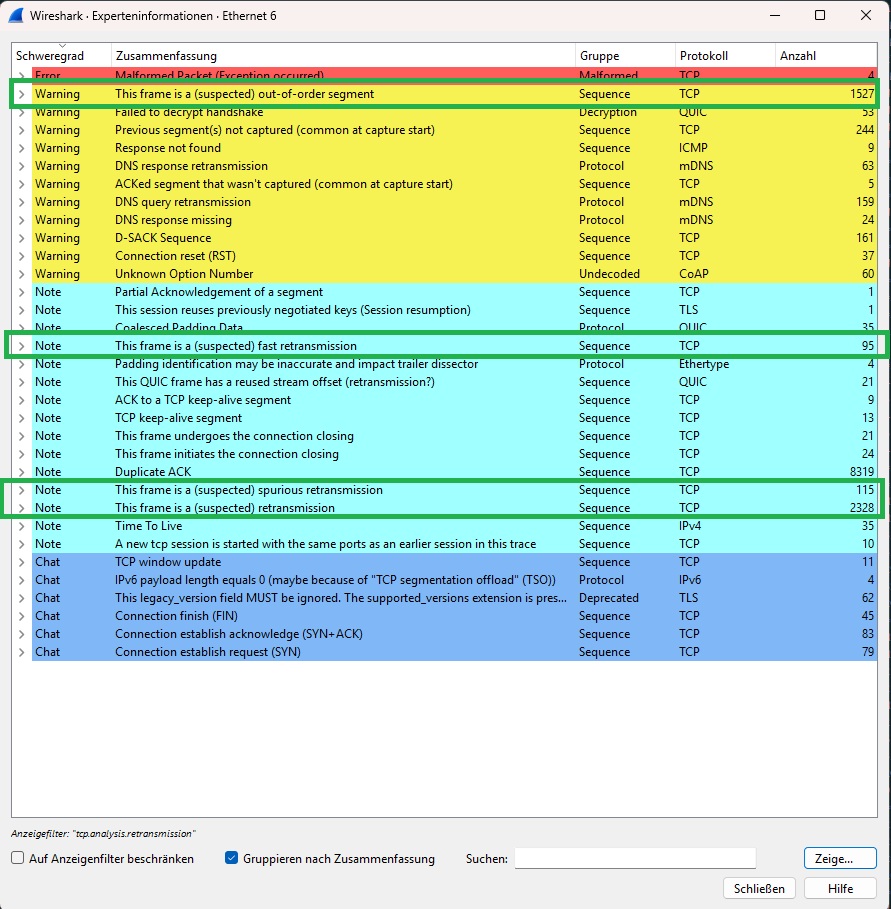
Gehe auf Analyze → Expert Information (in der deutschen Oberfläche: Analyse → Experteninformationen). Wireshark sortiert hier alle Auffälligkeiten nach Schweregrad: Error, Warning, Note und Chat. Lass dich davon nicht täuschen: Retransmissions stehen nur unter „Note“, können aber trotzdem die Ursache deines Performance-Problems sein.
Profi-Tipp: Statt über das Menü zu gehen, kannst du auch unten links in der Statusleiste auf den farbigen Kreis klicken.
Achte in der Expert Info besonders auf:
- Fast Retransmissions: Hier hat der Empfänger durch Duplicate ACKs signalisiert, dass ein Paket fehlt. Das ist „besser“ als ein Timeout, da der Sender nicht so lange warten muss.
- Previous segment not captured: Im Mitschnitt fehlt ein Stück des Datenstroms. Entweder ging das Paket vor deinem Messpunkt verloren – oder dein Messpunkt hat es nicht erfasst.
- Out-of-Order: Pakete kommen in falscher Reihenfolge an. Mögliche Ursachen sind Load-Balancing über mehrere Pfade (ECMP, Link-Aggregation mit falschem Hashing) oder ein Mitschnitt an einer Stelle, an der sich Pfade treffen. Wichtig: Wireshark entscheidet hier per Heuristik – manches „Out-of-Order“ ist in Wahrheit eine Retransmission.
4. Zeitabstände richtig messen
Die Anzahl der Retransmissions sagt dir, dass es ein Problem gibt. Wie sehr es die Anwender trifft, siehst du an der Zeit. Entscheidend ist dabei: Wie lange hat es gedauert, bis das verlorene Paket erneut gesendet wurde?
Am direktesten liest du das in den Paketdetails einer Retransmission ab. Unter [SEQ/ACK analysis] steht der Wert „The RTO for this segment was: …“ (tcp.analysis.rto). Das ist die Zeit seit dem Originalpaket. Über tcp.analysis.rto_frame springst du direkt dorthin. Mit Rechtsklick auf das Feld → Apply as Column machst du daraus eine Spalte, nach der du sortieren kannst. Noch schneller geht es mit einem Filter, der nur die langsamen Wiederholungen zeigt:
tcp.analysis.rto >= 0.2
Ergänzend nutze ich die Spalte „Time delta from previous captured frame“ (frame.time_delta). Sie zeigt, wie lange die Leitung vor der Retransmission still war. Falls sie fehlt: Rechtsklick auf die Spaltenüberschrift → Column Preferences → neue Spalte mit Type „Delta time“ anlegen. Lass den Filter tcp.analysis.retransmission aktiv und sortiere absteigend nach dieser Spalte. Die längsten Wartezeiten vor einer Retransmission stehen jetzt ganz oben.
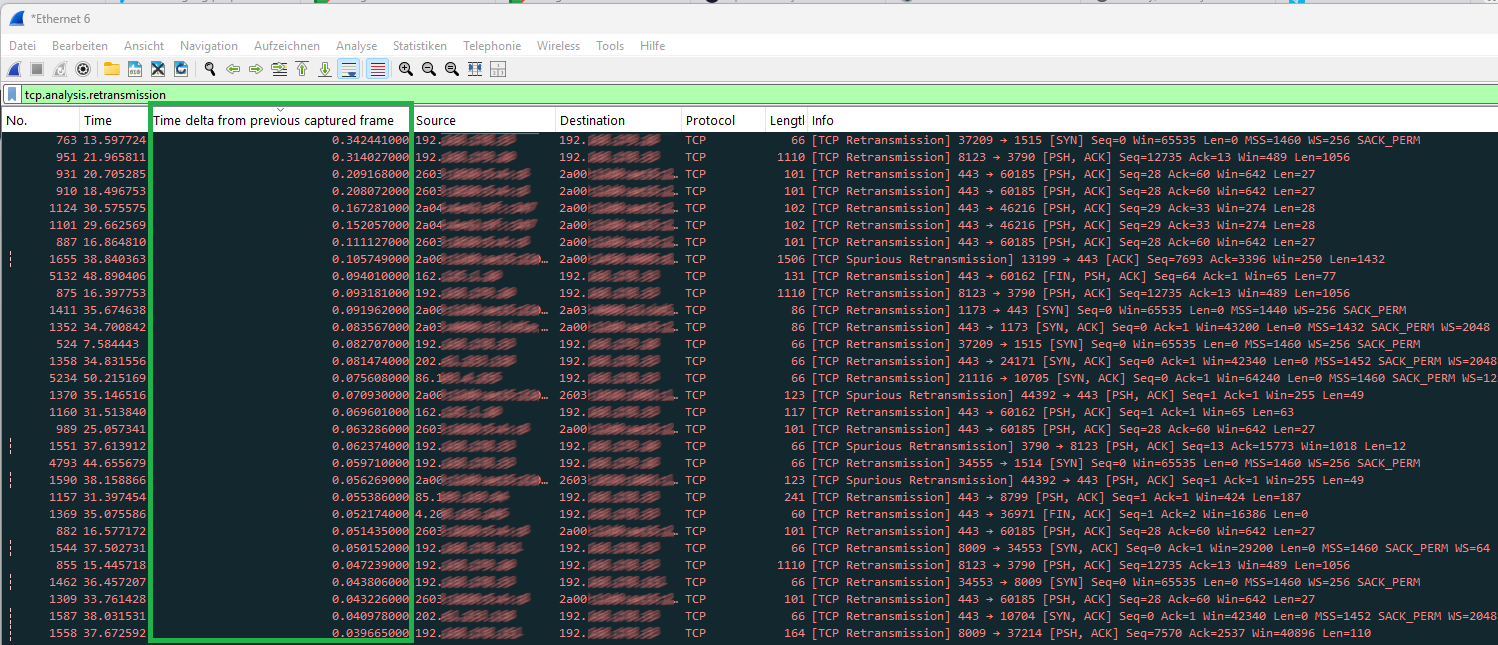
Liegen hier nur wenige Millisekunden, handelt es sich meist um Fast Retransmissions, die der Anwender kaum bemerkt. Siehst du dagegen mehrere hundert Millisekunden oder sogar Sekunden, stand die Übertragung in dieser Zeit still – das spüren die Anwender unmittelbar. Werte um 200–300 ms und deren Vielfache (600 ms, 1,2 s …) sind ein typischer Fingerabdruck von Timeout-Retransmissions mit Exponential Backoff.
Auch die Summe dieser Wartezeiten ist aufschlussreich: Zehn Retransmissions mit je 300 ms Pause bedeuten drei Sekunden reinen Stillstand – bei einer Anwendung, die eigentlich in einer Sekunde antworten sollte.
Achtung bei vollen Traces: „Previous captured frame“ ist das vorherige Paket im gesamten Mitschnitt. Laufen viele Verbindungen parallel, kann das ein Paket einer völlig anderen Session sein, und die Lücke wirkt kleiner, als sie ist. Grenze den Trace dann auf die betroffene Verbindung ein (Rechtsklick → Conversation Filter → TCP) oder nutze das Feld tcp.time_delta. Es misst den Abstand zum vorherigen Paket derselben TCP-Verbindung. Dafür musst du unter Edit → Preferences → Protocols → TCP die Option „Calculate conversation timestamps“ aktivieren.
Für das Gesamtbild lohnt sich zusätzlich ein Blick in Statistics → I/O Graphs. Lege dort einen Graphen mit dem Filter tcp.analysis.retransmission an. Verteilen sich die Retransmissions gleichmäßig über den ganzen Trace, deutet das eher auf einen Hardwarefehler hin. Treten sie gebündelt bei Lastspitzen auf, sprechen die Indizien für Überlast, Puffer- oder Policing-Probleme. Für eine einzelne Verbindung zeigt dir Statistics → TCP Stream Graphs → Stevens jede Retransmission als Rücksprung in der Sequenzlinie und jede Pause als waagerechtes Plateau. Wie du einen Stream insgesamt liest, erkläre ich unter Wie lese ich einen TCP Stream richtig?
5. Den Ort des Verlusts eingrenzen
Dass Pakete verloren gehen, weißt du jetzt. Die eigentliche Frage im Projekt lautet aber fast immer: Wo? Genau an diesem Punkt beginnt in vielen Unternehmen das Fingerpointing zwischen Netzwerk-, Server- und Applikationsteam.
Mit zwei zeitgleichen Mitschnitten lässt sich das sachlich klären: Ist ein Paket im Trace am Sender vorhanden, im Trace am Empfänger aber nicht, ging es auf dem Weg dazwischen verloren. Verschiebst du den zweiten Messpunkt schrittweise (z. B. vor und hinter die Firewall), grenzt du den Abschnitt immer weiter ein. Aus „Das Netz ist schuld“ wird so eine belegbare Aussage wie: Zwischen Messpunkt A und B gehen Pakete verloren, davor nicht.
Auch mit nur einem Mitschnitt gibt es Hinweise: Misst du am Sender, siehst du Original und Retransmission sowie die Duplicate ACKs, die zurückkommen – der Verlust liegt also stromabwärts. Misst du am Empfänger, zeigt sich zuerst eine Lücke („Previous segment not captured“) und später die nachgelieferte Retransmission, die Wireshark dort oft als „Out-of-Order“ markiert – der Verlust liegt stromaufwärts.
Häufige Ursachen: Woher kommen die Paketverluste?
In meiner Praxis kristallisiert sich immer wieder eine Handvoll üblicher Verdächtiger heraus:
A. Defekte Hardware (Layer 1)
Es klingt banal, aber ein geknicktes Glasfaserkabel, ein defektes oder verschmutztes SFP-Modul oder ein schlecht gecrimptes Cat6-Kabel stecken erstaunlich oft hinter den Problemen. Sie führen zu CRC-Fehlern auf den Switch-Ports, und das Paket wird verworfen. Ein Klassiker ist außerdem ein Duplex-Mismatch, wenn eine Seite fest konfiguriert ist und die andere auf Autonegotiation steht.
- Check: Prüfe die Interface-Counter deiner Switches, bei Cisco und vielen anderen Herstellern mit
show interfaces. Suche nach „Input Errors“, „CRC Errors“ und „Output Drops“ – und prüfe, ob die Zähler aktuell weiter steigen.
B. Überlast, Microbursts und Tail Drop
Wenn ein Switch oder Router mehr Daten empfängt, als er weiterleiten kann, füllt er seine Puffer. Sind diese voll, werden neue Pakete einfach verworfen (Tail Drop). Besonders kritisch ist dies an Übergängen von hoher auf niedrige Bandbreite, z. B. von 10 Gbit/s im Core auf 1 Gbit/s im Access. Tückisch sind Microbursts: Lastspitzen von wenigen Millisekunden, die in den üblichen 5-Minuten-Mittelwerten des Monitorings komplett verschwinden.
Das Gegenteil ist übrigens Bufferbloat: Hier sind die Puffer zu groß, Pakete werden nicht verworfen, sondern stauen sich. Das Symptom ist dann vor allem stark steigende Latenz statt Retransmissions.
C. MTU-Mismatches und Fragmentierung
Wenn ein Paket zu groß für einen Teilabschnitt des Weges ist (z. B. durch VPN-Header), muss es fragmentiert werden. Da moderne Betriebssysteme TCP-Pakete mit gesetztem „Don’t Fragment“-Bit verschicken, verwirft der Router das Paket und meldet per ICMP „Fragmentation Needed“ zurück. Wird diese Meldung von einer übervorsichtigen Firewall geblockt, entstehen sogenannte „Black Hole“-Router – und, du ahnst es, TCP Retransmissions.
Das Muster in Wireshark ist typisch: Der Handshake klappt, kleine Pakete gehen durch, aber volle Segmente werden immer wieder wiederholt, bis die Verbindung abbricht. Manche Betriebssysteme erkennen das nach einigen Fehlversuchen selbst und verkleinern die Segmente – dann läuft die Verbindung zwar, aber jede neue Session startet mit einer spürbaren Hängepartie. Ob ICMP-Meldungen überhaupt ankommen, prüfst du mit:
(icmp.type == 3 && icmp.code == 4) || icmpv6.type == 2
Welche MSS die beiden Seiten aushandeln, siehst du im TCP Handshake.
D. Security Appliances
Firewalls, IPS-Systeme und Deep Packet Inspection (DPI) können zum Nadelöhr werden. Wenn die CPU der Firewall bei Lastspitzen auf 100 % geht, ist das Erste, was sie tut: Pakete wegwerfen. Ein weiterer Klassiker ist asymmetrisches Routing: Hin- und Rückweg laufen über unterschiedliche Firewalls, die Session-Tabelle passt nicht, und Pakete werden verworfen.
E. Policing und Bandbreitenbegrenzung
Viele WAN- und MPLS-Anschlüsse sind beim Provider auf eine vertraglich vereinbarte Rate begrenzt. Wird diese per Policing durchgesetzt, verwirft der Provider jedes Paket oberhalb des Limits – ohne Puffer, ohne Vorwarnung. In deinem Monitoring sieht die Leitung dabei oft unauffällig aus. In Wireshark erkennst du das daran, dass Retransmissions immer dann auftreten, wenn eine Verbindung eine bestimmte Rate erreicht.
F. Endsysteme und Virtualisierung
Nicht jeder Verlust passiert im Netz. Läuft der Empfangspuffer (Ring Buffer) der Netzwerkkarte über oder kommt ein virtueller Switch auf dem Hypervisor an seine Grenzen, verwirft das Zielsystem die Pakete selbst. Hinweise liefern die Drop-Zähler von ethtool -S unter Linux, Get-NetAdapterStatistics unter Windows oder die Netzwerkansicht von esxtop (Spalte %DRPRX) auf VMware-Hosts. Liegt der Verlust hier, hilft kein Kabeltausch – dann sind Server- oder Virtualisierungsteam gefragt.
Vom Muster zur Ursache
Die folgende Übersicht hilft dir, das Bild aus Wireshark einem Verdächtigen zuzuordnen – und gleich die passende Gegenprobe zu machen:
| Muster im Trace | Wahrscheinliche Ursache | Gegenprobe |
|---|---|---|
| Retransmissions gleichmäßig verteilt, unabhängig von der Last | Layer 1: Kabel, SFP, Duplex-Mismatch | Interface-Counter (CRC, Input Errors) über die Zeit beobachten |
| Gehäuft bei Lastspitzen und großen Transfers | Überlast, Microbursts, Tail Drop | Output Drops an Übergängen von schnell auf langsam |
| Verlust setzt ab einer festen Rate pro Verbindung ein | Policing beim Provider | Vertragliche Rate prüfen, Shaping auf eigener Seite |
| Handshake klappt, volle Segmente hängen, kleine Pakete gehen durch | MTU-Problem, PMTUD Black Hole | ICMP-Filter oben, MSS im Handshake |
| Verlust nur auf einem Pfad oder nur in einer Richtung | Firewall-Last, asymmetrisches Routing | CPU und Drops der Firewall, Routing beider Richtungen |
| Paket am Switch-Port noch vorhanden, am Server nicht mehr | Endsystem, NIC-Puffer oder vSwitch | Drop-Zähler von NIC und Hypervisor |
Lösung & Best Practices: So bekommst du das Netz wieder schnell
Wenn wir die Ursache identifiziert haben, geht es an die Behebung. Hier sind die bewährten Strategien:
- Physische Schicht bereinigen: Tausche verdächtige Kabel und SFPs aus, setze die Fehlerzähler zurück und prüfe, ob sie stabil bleiben. Stelle die Duplex-Einstellung auf beiden Seiten identisch ein – am besten beide auf Autonegotiation. Ein „geht ja meistens“ reicht in modernen Hochgeschwindigkeitsnetzen nicht mehr aus.
- Puffer-Management: Prüfe, ob deine Switches ausreichend große Puffer („Deep Buffers“) haben, falls du viele Bursty-Workloads wie Backups oder Storage-Traffic hast – vor allem an Geschwindigkeitsübergängen.
- Shaping statt Policing: Wenn ein Anschluss auf eine Rate begrenzt ist, solltest du auf deiner Seite auf knapp unter diese Rate shapen. So werden Pakete gepuffert statt beim Provider verworfen. QoS sollte dabei Ende-zu-Ende konsistent konfiguriert sein – ein falsch konfiguriertes QoS kann das Überlastverhalten sogar verschlimmern.
- MSS Clamping: Bei VPN-Verbindungen ist MSS Clamping oft der Retter. Dabei wird die Maximum Segment Size im TCP-Handshake künstlich verringert, damit inklusive aller VPN-Header die MTU der Strecke nicht überschritten wird. Typische Werte liegen bei 1.452 Byte für PPPoE und um 1.350 Byte für IPsec-Tunnel. Und: ICMP „Fragmentation Needed“ gehört nicht pauschal in die Blockliste der Firewall.
- Firewalls und Routing entlasten: Prüfe CPU-Last und Drop-Zähler deiner Security Appliances zu den Zeitpunkten, an denen die Retransmissions auftreten. Sorge dafür, dass Hin- und Rückweg einer Verbindung über dieselbe Firewall laufen.
- SACK und Congestion Control prüfen: Mit Selective Acknowledgement (SACK) kann der Empfänger mehrere Lücken gleichzeitig melden, das beschleunigt die Erholung nach Verlusten deutlich. Ob SACK aktiv ist, siehst du im Handshake (
SACK_PERM). Auf Servern mit vielen Fernverbindungen kann zudem ein moderner Algorithmus wie BBR helfen. Wichtig: Ein größeres TCP Window behebt keinen Paketverlust – das ist Tuning am Symptom.
Fazit + Handlungsempfehlung
TCP Retransmissions sind mehr als nur ein technisches Detail – sie sind ein zuverlässiges Frühwarnsignal für den Zustand deiner Infrastruktur. Eine saubere Netzwerkanalyse mit Wireshark erlaubt es uns, weg vom „Raten und Tauschen“ hin zu einer evidenzbasierten Fehlerbehebung zu kommen.
Meine Empfehlung für dein weiteres Vorgehen:
- Führe bei Performance-Beschwerden immer eine Basismessung (Baseline) durch. Wie viele Retransmissions sind „normal“ in deinem Netz? Als Faustregel gilt: im LAN praktisch null, auf dedizierten WAN- und MPLS-Strecken deutlich unter 0,1 %, über Internet und VPN dauerhaft unter 0,5 %. Warum ein Ping hier keine Aussage liefert, liest du unter Packet Loss messen – warum Pings oft lügen.
- Schule deine Administratoren im Umgang mit Wireshark. Es ist das wichtigste Werkzeug im Werkzeugkasten.
- Wenn du an einen Punkt kommst, an dem du die Pakete siehst, aber die Ursache im komplexen Zusammenspiel der Protokolle nicht findest: Hol dir externe Expertise. Oft spart eine zweistündige Analyse durch einen Profi Tage an frustrierender Fehlersuche – und beendet die Diskussion, wessen Bereich schuld ist.
Für IT-Leiter heißt das ganz konkret: Bevor du in eine größere Leitung investierst, lass prüfen, ob die Bandbreite überhaupt der Engpass ist. Eine Paketanalyse kostet meist nur einen Bruchteil eines Leitungs-Upgrades – und liefert eine belastbare Aussage statt einer Vermutung.
Ein gesundes Netzwerk ist die Basis für jedes digitale Business. Lass nicht zu, dass TCP Retransmissions zu deinem unsichtbaren Bottleneck werden.
Du steckst gerade mitten in so einer Situation? Das Netzwerkteam sieht keine Fehler, das Applikationsteam auch nicht – und die Anwender warten trotzdem? Ob du aus dem Netzwerk, dem Applikationsbetrieb oder der IT-Leitung kommst: In einem kostenlosen Erstgespräch schauen wir gemeinsam, ob sich dein Problem mit einer Paketanalyse objektiv klären lässt. Hier geht es zum Kontaktformular.
💡 Praxis-Tipp:
Erfahre in diesem Artikel, wie sich Retransmissions im Gesamtbild äußern und wie du Performance-Engpässe im Gigabit-Netzwerk präzise lokalisierst.
Wie du Retransmissions im Zusammenhang einer einzelnen Verbindung liest, zeige ich dir in meinem Guide Wie lese ich einen TCP Stream richtig?
FAQ – Häufig gestellte Fragen
1. Wie viel Prozent TCP Retransmissions sind normal?
Im lokalen Netzwerk (LAN) sollten Retransmissions praktisch bei null liegen (unter 0,01 %). Auf dedizierten WAN- und MPLS-Strecken solltest du deutlich unter 0,1 % bleiben, über Internet und VPN sind 0,1 bis 0,5 % oft nicht ganz vermeidbar. Wie stark dich das trifft, hängt aber vor allem von der RTT und der Art der Anwendung ab: Bei 20 ms RTT begrenzen schon 0,1 % Verlust eine einzelne TCP-Verbindung auf rund 22 Mbit/s, und bei Anwendungen mit vielen kleinen Anfragen zählt weniger die Quote als die Zahl der Timeouts. Ab etwa 1 % wird es für Anwender fast immer spürbar. Beachte außerdem: Die Retransmission-Quote ist nur ein Näherungswert für die Verlustrate, weil auch unnötige Wiederholungen mitgezählt werden.
2. Was ist der Unterschied zwischen einer Retransmission und einer Spurious Retransmission?
Eine echte Retransmission tritt auf, wenn ein Paket tatsächlich verloren ging. Eine Spurious Retransmission (fälschliche Retransmission) liegt vor, wenn der Sender ein Paket erneut schickt, obwohl das Original längst angekommen ist – meist weil das ACK zu spät kam, etwa durch Latenzspitzen oder einen zu knapp bemessenen Timeout. Wireshark erkennt das, wenn die Daten bereits bestätigt wurden, und markiert sie entsprechend.
3. Kann WLAN die Ursache für Retransmissions sein?
Ja, absolut. WLAN ist ein „Shared Medium“ und sehr anfällig für Interferenzen. Auf Layer 2 gibt es eigene Wiederholungsmechanismen, aber wenn diese scheitern, schlägt der Fehler bis auf Layer 4 (TCP) durch und erzeugt dort Retransmissions. TCP hält den Funkverlust dann fälschlich für Überlast und drosselt zusätzlich.
4. Hilft mehr Bandbreite gegen Retransmissions?
Meistens nicht. Wenn die Retransmissions durch Paketverluste aufgrund von Hardwarefehlern oder MTU-Problemen entstehen, wird eine größere Leitung das Problem nicht lösen. Nur wenn die Ursache echte Überlast (Congestion) oder ein zu knappes Provider-Limit ist, hilft ein Upgrade.
5. Warum zeigt Wireshark so viele Retransmissions bei einer eigentlich schnellen Verbindung?
Dafür gibt es zwei häufige Gründe. Erstens: Verlustbasierte Congestion-Control-Algorithmen wie Reno oder CUBIC erhöhen die Senderate so lange, bis der Pfad überläuft und das erste Paket verworfen wird. Ein gewisses Maß an Retransmissions bei großen Datenübertragungen ist also systembedingt, sollte das Gesamtbild aber nicht dominieren. Zweitens: Der Mitschnitt selbst ist fehlerhaft, etwa durch einen überlasteten SPAN-Port oder einen Messrechner, der nicht hinterherkommt. Prüfe deshalb immer auch deinen Messaufbau.
6. Sind Retransmissions immer ein Netzwerkproblem?
Nein. Auch ein überlasteter Server kann Pakete verwerfen, zum Beispiel wenn die Empfangspuffer der Netzwerkkarte überlaufen oder ein virtueller Switch auf dem Hypervisor an seine Grenzen kommt (siehe Ursache F). Genau deshalb lohnt sich die Messung an mehreren Punkten: Sie zeigt objektiv, ob die Pakete im Netz oder erst auf dem Zielsystem verloren gehen.