Praxisfall: Wenn 2.500 Datenbank-Requests eine Anwendung lahmlegen – N+1 Query im Wireshark-Trace
Inhaltsverzeichnis
ToggleEs gibt Support-Tickets, die kennst du auswendig, bevor du sie öffnest: „Die Anwendung ist langsam. Bitte Netzwerk prüfen.“ In diesem Praxisfall zeige ich dir, wie eine paketbasierte Analyse einen wochenlangen Streit zwischen Applikationshersteller und IT-Abteilung beendet hat – und warum das Netzwerk am Ende freigesprochen wurde, obwohl die Symptome zunächst klar dagegen sprachen.
Der Fall ist anonymisiert und in Details verfremdet. Das technische Muster dahinter ist aber eines der häufigsten, die mir in der Applikationsanalyse begegnen: sequentielle Datenbank-Requests, besser bekannt als N+1 Query Problem. Als Admin bekommst du das konkrete Vorgehen im Trace, als Applikationsverantwortlicher die Erklärung, warum das Muster im Test nie auffällt – und als IT-Leiter die Antwort, warum mehr Bandbreite hier nichts bringt und was das Problem tatsächlich kostet.
Die Ausgangslage: Langsame Anwendung, ratlose Teams, Fingerpointing
Ein mittelständisches Unternehmen betreibt eine branchenspezifische Fachanwendung mit Oracle-Datenbank. Die Datenbank steht im zentralen Rechenzentrum, die Anwender arbeiten an mehreren Standorten und greifen mit einem klassischen Fat Client über das WAN darauf zu. Die Anwendung ist geschäftskritisch. Und genau diese Anwender melden seit Wochen dasselbe Problem: Das Öffnen einer einzigen Übersichtsmaske dauert über 30 Sekunden. Nicht nur beim ersten Start am Morgen, nicht sporadisch – sondern jedes Mal, reproduzierbar, an jedem Standort-Arbeitsplatz.
Was dann passierte, hast du vermutlich selbst schon erlebt. Der Applikationshersteller testet die Maske in seiner eigenen Umgebung, dort öffnet sie sich in gut einer Sekunde. Sein Schluss: „Bei uns läuft es, also liegt es an eurem Netzwerk.“ Die interne IT-Abteilung schaut auf ihre Monitoring-Dashboards: WAN-Auslastung im einstelligen Prozentbereich, Ping-Zeiten stabil, keine Interface-Errors, keine Discards. Aus ihrer Sicht ist das Netzwerk sauber – also muss es die Applikation sein.
Beide Seiten haben aus ihrer Perspektive recht. Beide haben Messwerte, die ihre Position stützen. Und genau deshalb bewegte sich seit Wochen nichts. Klassisches Fingerpointing: Jeder zeigt auf den anderen, die Anwender leiden weiter, und aus einem technischen Problem wird ein politisches.
An diesem Punkt kam ich ins Spiel – mit einem klaren Auftrag: Belege auf Paketebene, wo die Zeit tatsächlich verloren geht.
Warum das Monitoring nichts zeigt: Bandbreite ist nicht das Problem
Die meisten Monitoring-Systeme messen Durchsatz, Auslastung und Erreichbarkeit – typischerweise per SNMP in Intervallen von einer oder fünf Minuten. Das ist völlig legitim, um Kapazitätsprobleme oder Ausfälle zu erkennen. Aber eine Anwendung, die langsam ist, weil sie auf jede einzelne Antwort wartet, erzeugt in keiner dieser Metriken einen Ausschlag. Im Gegenteil: Sie überträgt auffällig wenig Daten. Und der Ping ist grün, weil die Latenz tatsächlich normal ist.
Daraus entsteht eine Situation, die auf den ersten Blick paradox wirkt: Die Anwendung ist quälend langsam, während das Netzwerk praktisch im Leerlauf ist. Wer nur auf Bandbreite schaut, sucht am falschen Ort. Warum eine Gigabit-Leitung eine Anwendung nicht automatisch schnell macht, habe ich ausführlich im Artikel Warum ist mein Netzwerk langsam trotz 1 Gbit? beschrieben – dieser Fall ist das Paradebeispiel dafür.
Die entscheidende Größe ist nicht die Bandbreite, sondern die Latenz in Kombination mit dem Kommunikationsverhalten der Applikation. Und genau das sieht man nur auf Paketebene.
Der Trace: Was Wireshark auf Paketebene sichtbar macht
Das Vorgehen war bewusst beidseitig angelegt: ein Mitschnitt am Client im Standort, ein Mitschnitt direkt am Datenbankserver – zeitgleich, während ein Anwender exakt den problematischen Maskenaufbau durchführt. Der beidseitige Trace ist entscheidend, weil er später die Frage beantwortet, wo gewartet wird: im Netz, am Server oder am Client. Intern lief der relevante Mitschnitt unter der Bezeichnung Trace 07/23.
Der erste Blick galt den üblichen Verdächtigen – und die waren alle unschuldig:
- Kein Packet Loss: Keine einzige Retransmission, keine Duplicate ACKs, keine Zero-Window-Ereignisse. Der Filter
tcp.analysis.flags && !tcp.analysis.window_updatelieferte keinen einzigen Treffer. Warum ein grüner Ping hier wenig aussagt, liest du im Beitrag Packet Loss messen – warum Pings oft lügen. - Unauffällige Round Trip Time: Die RTT zwischen Standort-Client und Datenbankserver lag stabil bei etwa 10 bis 15 Millisekunden – für eine WAN-Strecke dieser Entfernung ein völlig normaler Wert. Wie du RTT sauber misst und bewertest, findest du im Beitrag Hohe Latenz im Firmennetz – RTT analysieren.
- Saubere TCP-Verbindung: Handshake unauffällig, Window-Größen ausreichend, keine Anzeichen für Engpässe auf Transportebene.
Nach zwanzig Minuten war klar: Das Netzwerk transportiert jedes Paket schnell und fehlerfrei. Und trotzdem dauert die Maske über 30 Sekunden. Die Zeit musste also woanders stecken.
Erste Auffälligkeit: Ping-Pong statt Datenstrom
Bei einer performanten Datenübertragung zeigt ein TCP-Stream typischerweise Bursts: viele volle Segmente hintereinander, der Durchsatz steigt. Wie man solche Streams liest, habe ich im Grundlagenartikel Wie lese ich einen TCP Stream richtig? beschrieben.
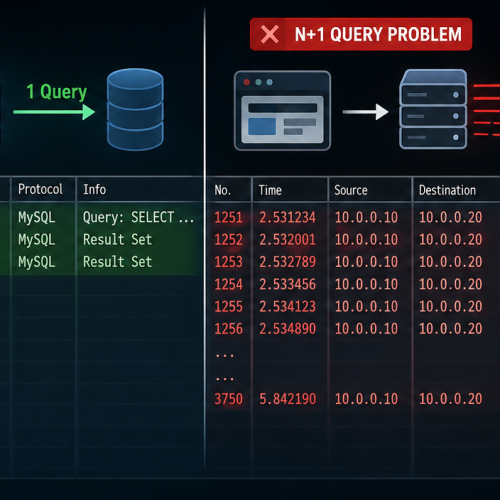
Dieser Trace sah völlig anders aus. Statt Bursts zeigte sich ein streng abwechselndes Muster: Der Client sendet einen kleinen Request (wenige hundert Bytes), der Server antwortet mit einer kleinen Response, erst dann sendet der Client den nächsten Request. Immer schön der Reihe nach, nie parallel, nie überlappend. Ein permanentes Ping-Pong.
Im IO Graph war das gut zu sehen: keine Durchsatzspitzen, sondern über die gesamte Ladezeit eine flache, niedrige Linie aus tausenden Mini-Transaktionen. Die Verbindung war zu keinem Zeitpunkt auch nur ansatzweise ausgelastet – sie war beschäftigt mit Warten.
Das Muster erkennen: 1 Query für die Liste, N Queries für die Details
Der Blick in die Oracle-Kommunikation, die Wireshark mit dem Dissector tns dekodiert, machte das Muster dann greifbar. Zu Beginn des Maskenaufbaus setzt die Anwendung eine einzige Abfrage ab, die eine Liste von Datensätzen zurückliefert – die Einträge, die in der Übersichtsmaske angezeigt werden sollen.
Dann kommt der entscheidende Teil: Für jeden einzelnen Listeneintrag folgt eine separate Detailabfrage. Ein Eintrag, ein Query. Der nächste Eintrag, der nächste Query. Bei rund 2.500 Einträgen in der Liste ergibt das rund 2.500 zusätzliche Einzelabfragen – jede für sich winzig, jede für sich schnell beantwortet, aber jede wartet auf die vollständige Antwort der vorherigen, bevor sie abgeschickt wird.
Übrigens: Auch wenn die Verbindung verschlüsselt ist, etwa per Oracle Native Network Encryption oder TLS, bleibt das Muster erkennbar. Tausende nahezu gleich große Requests im immer gleichen Takt verraten es auch ohne Blick in den Inhalt.
Damit war das Muster eindeutig identifiziert: das klassische N+1 Query Problem. Eine Abfrage für die Liste, N Abfragen für die Details.
Das N+1-Query-Problem einfach erklärt
Das N+1-Pattern entsteht meist nicht aus Nachlässigkeit, sondern aus der Art, wie viele Anwendungen und Frameworks mit Daten umgehen. Die Logik ist aus Entwicklersicht naheliegend: „Hole mir die Liste. Und für jedes Element der Liste hole mir die Details.“ Vereinfacht sieht das so aus – zuerst die Liste:
SELECT id, kunde, datum FROM auftraege WHERE status = ‘offen’
Danach folgt in einer Schleife für jeden Eintrag einzeln diese Abfrage, jeweils mit der ID des Eintrags als Bind-Variable:
SELECT position, artikel, menge FROM auftragspositionen WHERE auftrag_id = :id
Besonders häufig steckt das Muster in ORM-Frameworks wie Hibernate oder Entity Framework, wenn verknüpfte Daten per Lazy Loading erst beim ersten Zugriff nachgeladen werden. Im Code sieht das völlig harmlos aus – eine einfache Schleife über eine Liste. Dass dahinter tausende Datenbankzugriffe stehen, sieht man der Zeile nicht an.
Warum das Problem im Test nie auffällt
In der Entwicklungsumgebung funktioniert das tadellos, denn dort liegt die Datenbank im selben Rack und die RTT beträgt Bruchteile einer Millisekunde. Dasselbe galt für die Testumgebung des Herstellers – und, wie sich später zeigte, auch für die Arbeitsplätze in der Zentrale.
An den Standorten sieht die Welt anders aus. Zwischen Client und Datenbank liegen Switches, Router, Firewalls und eine WAN-Strecke über viele Kilometer. Und die Latenz hat eine physikalische Untergrenze: Licht legt in der Glasfaser rund 200 Kilometer pro Millisekunde zurück. Jeweils 100 Kilometer Entfernung kosten also schon etwa eine Millisekunde RTT – bevor überhaupt ein Router oder eine Firewall mitspielt. Eine RTT von 10 bis 15 Millisekunden ist für eine Standortanbindung deshalb völlig normal. Für eine Abfrage ist das irrelevant. Für 2.500 streng sequentielle Abfragen ist es fatal.
Die Mathematik dahinter: Round Trips × RTT = Wartezeit
Der Kern des Problems lässt sich in einer einzigen Formel ausdrücken:
Wartezeit ≈ Anzahl sequentieller Round Trips × RTT
Wichtig ist das Wort Round Trips: Gezählt wird jede Runde, in der die Anwendung eine Anfrage schickt und auf die Antwort wartet. Je nach Treiber und Abfrage kann ein einzelner Query auch mehrere Round Trips auslösen, etwa wenn Parse, Execute und Fetch getrennt übertragen werden. In diesem Fall war es genau ein Round Trip pro Detailabfrage. Setzen wir die Werte aus dem Trace ein:
2.500 Round Trips × 12 ms RTT = 30.000 ms = 30 Sekunden
Das deckt sich fast exakt mit dem, was die Anwender erleben – 30 Sekunden reine Netzwerk-Wartezeit bei praktisch 0 % Auslastung. Kein Paket ging verloren, kein Paket war langsam. Die Anwendung wartet schlicht 2.500 Mal hintereinander eine komplette Runde durch das Netz ab. Den kleinen Rest bis zur gemessenen Gesamtzeit liefern Listenabfrage und Client-Verarbeitung.
Zum Vergleich dieselbe Rechnung für einen Arbeitsplatz in der Zentrale mit 0,5 ms RTT zur Datenbank:
2.500 Round Trips × 0,5 ms RTT = 1.250 ms ≈ 1,3 Sekunden
Gleiche Anwendung, gleiche Maske, gleiche Datenbank – und trotzdem der Unterschied zwischen „etwas träge“ und „unbenutzbar“. Genau deshalb fällt das Muster im Test nicht auf, und genau deshalb wirkt es von außen wie ein Netzwerkproblem.
Und hier liegt die unbequeme Wahrheit für alle, die reflexartig mehr Bandbreite fordern: In dieser Rechnung kommt Bandbreite nicht vor. Ob die Standortleitung 100 Mbit/s oder 10 Gbit/s hat, ändert am Ergebnis nichts. Die einzige netzwerkseitige Stellschraube wäre die RTT – und die war für die Entfernung bereits gut. Selbst wenn du sie halbieren könntest, was physikalisch kaum machbar ist, würde die Maske immer noch 15 Sekunden laden. Die eigentliche Stellschraube ist die Anzahl der sequentiellen Round Trips – und die kontrolliert allein die Applikation.
Was das im Alltag kostet
Für IT-Leiter und Entscheider lohnt sich eine einfache Hochrechnung. Angenommen, 40 Anwender öffnen die Maske jeweils 15-mal am Tag:
40 Anwender × 15 Aufrufe × 30 s = 18.000 s = 5 Stunden Wartezeit pro Tag
Das sind über 100 Stunden im Monat vor einer Sanduhr – plus Frust, Excel-Schattenlisten und die Zeit, die Netzwerkteam, Applikationsbetreuung und Hersteller in Ticket-Schleifen stecken. Eine gezielte Analyse ist dagegen meist eine Sache von wenigen Tagen.
Die Beweisführung: So grenzt du Netzwerk vs. Applikation sauber ab
Ein Befund ist nur so gut wie seine Beweisführung. Gerade beim Fingerpointing muss die Analyse so belastbar sein, dass beide Seiten sie akzeptieren. Wie du grundsätzlich strukturiert vorgehst, beschreibe ich in der 5-Schritte-Methodik zur systematischen Eingrenzung.
Die Kernfrage lautet: Wer verursacht die Wartezeit – das Netz, der Server oder der Client? Mit Mitschnitten auf beiden Seiten zerlegst du dafür jede einzelne Transaktion in ihre Zeitanteile:
- Antwortzeit am Client: Zeit zwischen dem Absenden des Requests und dem Eintreffen der Response im clientseitigen Trace. Darin steckt alles: die Netzlaufzeit hin und zurück plus die Verarbeitung am Server.
- Verarbeitungszeit am Server: Zeit zwischen dem Eintreffen des Requests und dem Absenden der Response im serverseitigen Trace. Das ist die reine Arbeitszeit der Datenbank.
- Netzlaufzeit: Die Differenz aus beiden Werten. Das ist die Zeit, die die Pakete tatsächlich unterwegs waren.
- Clientseitige Denkzeit: Zeit zwischen dem Empfang einer vollständigen Response und dem Absenden des nächsten Requests. Das ist die Zeit, die die Applikation selbst verbraucht.
Ein praktischer Nebeneffekt: Für diese Zerlegung müssen die Uhren von Client und Server nicht exakt synchron laufen, weil du nur Zeitdifferenzen innerhalb des jeweiligen Traces vergleichst. Als Plausibilitätscheck für die reine Netzlaufzeit eignet sich zusätzlich das Feld tcp.analysis.initial_rtt, das Wireshark aus dem TCP Handshake berechnet.
In diesem Fall zeigte die Zerlegung ein klares Bild: Die Datenbank verarbeitete jede Einzelabfrage in unter einer Millisekunde. Die Netzlaufzeit lag konstant bei rund 12 ms. Die clientseitige Denkzeit zwischen zwei Requests war kaum messbar. Die Wartezeit ergab sich fast vollständig aus RTT × Anzahl der Round Trips. Weder Netz noch Datenbankserver hatten ein Performanceproblem. Das Kommunikationsmuster war das Problem.
Welche Wireshark-Filter und -Funktionen dabei helfen
Die wichtigste Einzelmetrik für diese Art von Analyse ist der Zeitabstand zum vorherigen Paket innerhalb desselben TCP-Streams:
tcp.time_delta
Dieses Feld blendest du dir am besten als eigene Spalte ein: Paket auswählen, im Paketdetail unter TCP den Knoten [Timestamps] aufklappen, Rechtsklick auf „Time since previous frame in this TCP stream“ und Apply as Column. Taucht der Knoten nicht auf, aktivierst du unter Edit → Preferences → Protocols → TCP die Option Calculate conversation timestamps.
Richtig aussagekräftig wird das Feld, wenn du die Richtung mitfilterst. Im clientseitigen Trace zeigt dir dieser Filter alle Datenpakete vom Datenbankserver, auf die der Client länger als 8 ms gewartet hat. Port 1521 ist der Standardport des Oracle-Listeners, den passt du gegebenenfalls an:
tcp.stream == 5 && tcp.srcport == 1521 && tcp.len > 0 && tcp.time_delta > 0.008
In diesem Fall lieferte der Filter rund 2.500 Treffer, vor jedem eine Lücke von etwa 12 ms. Jeder Treffer ist eine Response, auf die der Client eine volle Netzrunde gewartet hat. Die Gegenprobe zeigt die Denkzeit des Clients, also die Pausen vor seinen eigenen Requests:
tcp.stream == 5 && tcp.dstport == 1521 && tcp.len > 0 && tcp.time_delta > 0.008
Hier blieb die Liste praktisch leer. Der Client hat nach jeder Antwort sofort den nächsten Request geschickt – er hat nicht gerechnet, er hat gewartet. Den Schwellwert wählst du knapp unterhalb der gemessenen RTT, die Stream-Nummer passt du an deinen Trace an. Der Zusatz tcp.len > 0 blendet reine ACKs aus, damit nur Pakete mit Nutzdaten übrig bleiben.
Für die Gesamtbetrachtung sind außerdem drei Bordmittel von Wireshark Gold wert:
- Statistics → Conversations: Zeigt dir pro TCP-Verbindung die Anzahl der Pakete, Bytes und die Dauer. Eine Verbindung mit mehreren tausend kleinen Paketen und minimalem Datenvolumen über 30 Sekunden ist bereits der halbe Befund.
- Statistics → I/O Graphs: Visualisiert das Ping-Pong-Muster – ideal auch für den Bericht an nicht-technische Entscheider. Mit einem Intervall von 100 ms zeigt sich über die gesamte Ladezeit eine gleichmäßig niedrige Paketrate statt Durchsatz-Bursts. Ein Bild, das die ganze Geschichte erzählt.
- Statistics → TCP Stream Graphs → Round Trip Time: Belegt, dass die RTT konstant und unauffällig war – der Freispruch für das Netzwerk in grafischer Form. Zeigt der Graph kaum Punkte, wechselst du mit Switch Direction die Richtung.
Wenn du mit Display-Filtern noch nicht sattelfest bist: Im Beitrag Wireshark – Die 10 wichtigsten Display-Filter findest du das Handwerkszeug, das du für genau solche Analysen brauchst.
Die Gegenprobe auf der Datenbank
Hersteller und Applikationsbetreuer überzeugt oft zusätzlich ein Beleg aus ihrer eigenen Welt. Bei Oracle bietet sich die Ausführungsstatistik an: In V$SQL taucht das Detail-Statement mit einem Wert in der Spalte EXECUTIONS auf, der zur Anzahl der Listeneinträge passt. Und die Sitzungsstatistik SQL*Net roundtrips to/from client steigt pro Maskenaufbau um rund 2.500. Wenn Paketdaten und Datenbankstatistik dasselbe sagen, ist die Diskussion beendet.
Das Ergebnis: Klare Fakten statt Schuldzuweisungen
Am Ende der Analyse stand ein Bericht, der beide Streitparteien an einen Tisch brachte – nicht mit Meinungen, sondern mit Paketdaten. Die Kernaussagen im Überblick:
| Verdacht | Befund im Trace | Bewertung |
|---|---|---|
| Packet Loss / Retransmissions | Keine Retransmissions, keine Duplicate ACKs, keine Zero Windows | Netzwerk entlastet |
| Zu wenig Bandbreite | Leitung während des Maskenaufbaus praktisch im Leerlauf | Netzwerk entlastet |
| Hohe Latenz im Netz | RTT konstant 10–15 ms, für die Entfernung normal, keine Ausreißer | Netzwerk entlastet |
| Langsamer Datenbankserver | Verarbeitungszeit pro Query unter 1 ms | Server entlastet |
| Langsamer Client | Denkzeit zwischen den Requests kaum messbar | Client entlastet |
| Datenzugriffsmuster der Applikation | ~2.500 streng sequentielle Einzelabfragen pro Maskenaufbau (N+1) | Ursache bestätigt |
Sobald die Paketdaten auf dem Tisch lagen, war der Konflikt in einem einzigen Termin beigelegt. Der Hersteller nahm die Optimierung in seine Entwicklung auf, die IT-Abteilung war rehabilitiert, und die Anwender bekamen eine realistische Perspektive. Mit einem Wireshark-Trace, in dem jede Millisekunde nachvollziehbar zugeordnet ist, lässt sich schlecht diskutieren.
Die Empfehlungen: kurzfristig, mittelfristig, dauerhaft
Kurzfristig als Workaround: Den Client näher an die Datenbank bringen. Läuft die Fachanwendung auf einem Terminalserver oder in einer Citrix-Umgebung im selben Rechenzentrum wie die Datenbank, sinkt die RTT zwischen Client und Datenbank auf unter eine Millisekunde – und die Maske lädt in rund einer Sekunde. Über das WAN laufen dann nur noch Bildschirminhalte. Das ist kein Fix, sondern Schadensbegrenzung, verschafft dem Hersteller aber Zeit.
Mittelfristig als eigentlicher Fix: Die Detailabfragen bündeln. Statt 2.500 Einzelabfragen lädt die Anwendung die Details für alle Listeneinträge in einer Abfrage per Join:
SELECT a.id, a.kunde, a.datum, p.position, p.artikel, p.menge FROM auftraege a JOIN auftragspositionen p ON p.auftrag_id = a.id WHERE a.status = ‘offen’
Alternativ funktionieren wenige Abfragen mit IN-Liste. Dabei gilt: Oracle erlaubt maximal 1.000 Werte pro IN-Liste, größere Mengen müssen also in Blöcke aufgeteilt werden. In ORM-Frameworks heißen die Stichworte Eager Loading bzw. Batch Fetching statt Lazy Loading.
Begleitend: Die Fetch Size erhöhen, bei Oracle auch Array Size oder Row Prefetch genannt. Sobald die Details in einer großen Ergebnismenge kommen, holt der Treiber diese sonst in kleinen Portionen ab – der Oracle-JDBC-Treiber zum Beispiel standardmäßig nur 10 Zeilen pro Round Trip. Ohne Anpassung entstehen so wieder hunderte Round Trips, nur an anderer Stelle.
Dauerhaft: In Entwicklung und Test mit realistischer Latenz arbeiten. Auf einem Linux-Testsystem genügt dafür ein einziger Befehl, der jedes ausgehende Paket auf der Schnittstelle um 12 ms verzögert:
sudo tc qdisc add dev eth0 root netem delay 12ms
Mit sudo tc qdisc del dev eth0 root ist die Verzögerung wieder weg. Unter Windows leistet das Open-Source-Tool clumsy Ähnliches. Wer seine Anwendung so testet, findet N+1-Muster, bevor sie beim Kunden ankommen.
Was du aus diesem Fall mitnehmen kannst
- Grünes Monitoring beweist weder Schuld noch Unschuld des Netzwerks. Für latenzgetriebene Applikationsprobleme sind Bandbreiten- und Ping-Dashboards das falsche Werkzeug.
- Latenz schlägt Bandbreite. Bei sequentiellen Request-Response-Mustern bestimmt allein RTT × Anzahl der Round Trips die Wartezeit. Mehr Bandbreite hilft exakt gar nichts.
- „Bei uns läuft es“ beweist nichts. Entscheidend ist die RTT am echten Arbeitsplatz, nicht im Testlabor.
- Beidseitig tracen lohnt sich. Nur so trennst du Netzlaufzeit, Server-Verarbeitung und Client-Denkzeit sauber.
tcp.time_deltaist deine wichtigste Spalte. Kombiniert mit einem Richtungsfilter zeigt sie, auf welcher Seite die Zeit verloren geht.- Das N+1-Pattern ist häufiger, als du denkst. Es versteckt sich in Fachanwendungen, ORM-Frameworks und Eigenentwicklungen. Verwandte Muster findest du im Praxisfall SQL über WAN-Strecke und im Beitrag Single-Threading als Performance-Killer.
- Fakten beenden Fingerpointing. Eine saubere Beweisführung ist fast immer günstiger als Wochen des Stillstands.
Fazit: Paketdaten lügen nicht
Wochenlang standen sich zwei Parteien mit plausiblen, aber unvollständigen Messwerten gegenüber. Der Wireshark-Trace hat die Diskussion in einem Termin beendet – nicht weil er lauter argumentiert hätte, sondern weil er jede einzelne Millisekunde der Wartezeit einer Ursache zuordnen konnte.
Das Netzwerk war unschuldig. Die Datenbank war unschuldig. Verantwortlich war ein Kommunikationsmuster, das in der Entwicklungsumgebung unsichtbar bleibt und im Unternehmensnetz zur Bremse wird: 2.500 sequentielle Requests, jeder eine RTT lang wartend.
Wenn du selbst gerade vor einer langsamen Anwendung stehst, deren Monitoring keinerlei Auffälligkeiten zeigt: Genau dann ist der richtige Zeitpunkt für einen Blick in den Trace. Denn am Ende gilt, was in jedem meiner Fälle gilt – Paketdaten lügen nicht.
Ob du im Netzwerkteam sitzt und dich gegen den nächsten „Das liegt am Netz“-Vorwurf wehren musst, ob du die Anwendung betreust und endlich wissen willst, wo die Zeit hängen bleibt, oder ob du als IT-Leiter seit Wochen zwischen Hersteller und eigener IT vermittelst: Eine paketbasierte Analyse bringt Fakten auf den Tisch, die alle Beteiligten akzeptieren. Wie so eine Analyse bei mir abläuft, findest du in der Übersicht meiner Leistungen. Und wenn du deinen Fall direkt besprechen möchtest: Vereinbare ein kostenloses Erstgespräch.