Netzwerkprobleme systematisch eingrenzen: Die 5-Schritte-Methodik für eine belastbare Fehlersuche
Inhaltsverzeichnis
ToggleMontag, kurz nach neun. Im Ticketsystem steht: „Programm extrem langsam, bitte dringend prüfen.“ Das Netzwerkteam öffnet das Monitoring. Alle Interfaces sind grün, die Auslastung liegt bei 12 Prozent. Das Ergebnis: „Netz ist ok.“ Das Applikationsteam schaut auf den Server. CPU bei 30 Prozent, genug RAM, keine Fehler im Eventlog. Dort heißt es: „Server ist ok.“ Und der Anwender wartet weiterhin 20 Sekunden, bis sich seine Maske öffnet.
Diese Situation begegnet mir in fast jedem Analyseprojekt. Jedes Team hat ein Dashboard mit grünen Häkchen, und trotzdem ist das Problem da. Ab diesem Punkt beginnt meistens das Fingerpointing. Jede Seite belegt, dass es an der eigenen Komponente nicht liegen kann. Herausfinden, woran es tatsächlich liegt, will keiner.
Danach wird es schnell teuer. Ein Switch wird auf Verdacht getauscht, die Firmware aktualisiert, der Server bekommt mehr RAM, eine schnellere Leitung wird bestellt. Wochen vergehen. Manchmal verschwindet das Problem zufällig, niemand weiß warum, und drei Monate später ist es wieder da. Raten und Komponenten-Tausch kosten Geld, Zeit und Vertrauen zwischen den Teams.
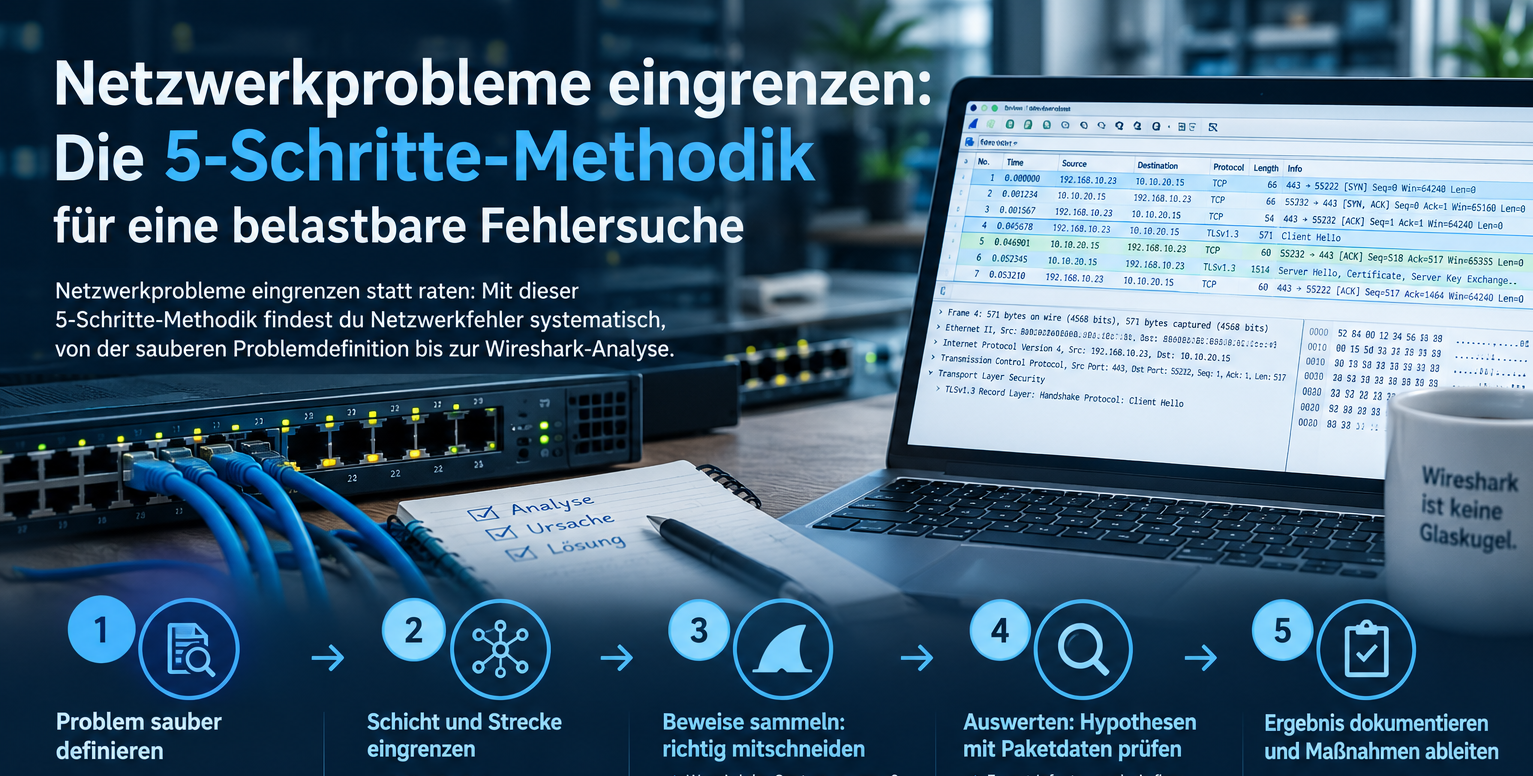
Ein Problem, das man nicht versteht, lässt sich nicht beheben. Warum eine Leitung mit 1 Gbit trotzdem langsam sein kann, habe ich im Artikel Warum ist mein Netzwerk langsam trotz 1 Gbit? beschrieben. In diesem Beitrag zeige ich dir die Methodik, mit der ich Netzwerkprobleme systematisch eingrenze. Sie besteht aus fünf Schritten: Problem definieren, Schicht und Strecke eingrenzen, Beweise sammeln, mit Paketdaten auswerten und das Ergebnis so dokumentieren, dass beide Teams es nachvollziehen können.
Warum unstrukturierte Fehlersuche scheitert
Die meisten Fehlersuchen scheitern nicht an fehlendem Fachwissen. In den Teams sitzen fast immer kompetente Leute. Es fehlt an der Methode. Vier Muster sehe ich immer wieder:
- Symptom und Ursache werden verwechselt. Retransmissions im Mitschnitt sind ein Symptom. Ob ein defektes Kabel, ein überlaufender Puffer oder ein überlasteter Server dahintersteckt, sagen sie allein nicht.
- Das Bauchgefühl entscheidet. „Letztes Mal war es die Firewall“ ist ein Erfahrungswert, aber kein Beweis. Wer nur seiner ersten Hypothese nachgeht, übersieht die zweite.
- Es fehlen echte Messdaten. Monitoring-Werte sind gemittelt, Logs zeigen nur, was jemand vorher als loggenswert definiert hat. Über das Timing einzelner Transaktionen sagt beides wenig.
- Die Teams verteidigen sich gegenseitig. Wenn jedes Team nur prüft, ob es selbst schuld ist, schaut sich niemand die Strecke als Ganzes an. Das Problem liegt dann im Niemandsland zwischen den Zuständigkeiten.
Eine strukturierte Netzwerk-Troubleshooting-Methodik setzt genau hier an. Sie ersetzt Meinungen durch Messwerte und sorgt dafür, dass am Ende ein Ergebnis steht, das niemand mehr wegdiskutieren muss.
Schritt 1 – Problem sauber definieren
„Es ist langsam“ ist keine Problembeschreibung. Mit diesem Satz kannst du nicht messen, nicht vergleichen und später auch nicht prüfen, ob deine Maßnahme etwas gebracht hat. Bevor du irgendein Werkzeug öffnest, brauchst du eine präzise Definition.
Die W-Fragen
- Wer ist betroffen? Ein Benutzer, eine Abteilung, ein Standort, alle?
- Was genau ist langsam oder bricht ab? Eine Anwendung, eine bestimmte Funktion, ein Dateizugriff?
- Wann tritt es auf? Dauerhaft, morgens zum Arbeitsbeginn, zu bestimmten Uhrzeiten, seit einem bestimmten Datum?
- Wo tritt es auf? An welchem Standort, in welchem VLAN, über WLAN oder LAN, im Homeoffice?
- Ist es reproduzierbar? Kannst du es gezielt auslösen, oder tritt es sporadisch auf?
Vom Gefühl zur Zahl
Das Ziel ist ein messbares Symptom. Ein Beispiel: „Das Öffnen der Kundenakte im ERP dauert am Standort Nord 14 Sekunden, in der Zentrale 2 Sekunden. Betroffen sind alle Clients am Standort, seit letztem Dienstag, jederzeit reproduzierbar.“ Mit diesem Satz lässt sich arbeiten. Er enthält eine Zeit, einen Vergleich und einen Startpunkt.
Frag dabei konkret nach, was sich seit „letztem Dienstag“ geändert hat. Ein Update, eine neue Firewall-Regel, ein Wechsel des Providers oder ein umgezogener Server. Änderungen sind oft der schnellste Hinweis. Ein Beweis sind sie aber erst nach der Messung.
Ohne Baseline kein Vergleich
Die vielleicht wichtigste Frage in diesem Schritt lautet: Was ist eigentlich normal? Wenn niemand weiß, wie lange die Aktion früher gedauert hat oder wie lange sie an einem anderen Standort dauert, fehlt der Bezugspunkt. Hast du keine historische Baseline, dann schaffe dir eine: Miss dieselbe Aktion an einem Ort, an dem sie gut funktioniert.
Schritt 2 – Schicht und Strecke eingrenzen
Jetzt geht es darum, den Suchraum zu verkleinern. Du denkst dabei in zwei Dimensionen: in Schichten (OSI- beziehungsweise TCP/IP-Modell) und entlang der Strecke vom Client zum Server.
Die Schichtensicht
Ein Verbindungsabbruch auf Layer 1 sieht anders aus als ein DNS-Problem auf Layer 7. Kommt der Client überhaupt ins Netz? Funktioniert die Namensauflösung? Kommt der TCP-Handshake zustande? Läuft die TLS-Aushandlung durch? Antwortet die Anwendung? Wenn du von unten nach oben prüfst, weißt du schnell, auf welcher Ebene es klemmt. Geht es nicht um Langsamkeit, sondern um Abbrüche, findest du das passende Vorgehen im Beitrag Verbindungsabbrüche analysieren mit Wireshark.
Die Streckensicht
Zeichne die Strecke auf. Auf ein Blatt Papier, ernsthaft. Client, Access-Switch, Core, WAN oder VPN, Firewall, eventuell Proxy oder Load Balancer, Applikationsserver, Datenbank. Jede dieser Stationen kann Verzögerung oder Paketverlust verursachen. Häufig zeigt sich schon dabei, dass ein Teil der Strecke niemandem so richtig gehört.
Ausschlussverfahren: Was funktioniert, was nicht?
Das stärkste Werkzeug in diesem Schritt ist der Vergleich mit einem unbeteiligten Client oder Standort (Kreuztest). Ein paar typische Schlüsse:
- Ist die Anwendung auch in der Zentrale langsam, direkt neben dem Server? Dann ist die WAN-Strecke sehr wahrscheinlich nicht die Ursache.
- Sind am betroffenen Standort andere Anwendungen schnell? Dann ist eine allgemein überlastete Leitung unwahrscheinlich.
- Ist nur ein Client betroffen, der Nachbar-PC am selben Switch aber nicht? Dann rückt der Client selbst in den Fokus: Treiber, Virenscanner, Proxy-Einstellungen.
- Tritt das Problem nur über VPN auf? Dann schau dir MTU, Fragmentierung und das VPN-Gateway genauer an.
Am Ende dieses Schritts hast du keine Lösung, aber eine Hypothese mit begrenztem Suchraum. Genau die brauchst du, um im nächsten Schritt an der richtigen Stelle zu messen.
Schritt 3 – Beweise sammeln: richtig mitschneiden
Ab hier wird es technisch. Ein Paketmitschnitt ist das einzige Werkzeug, das dir lückenlos zeigt, was an deinem Messpunkt tatsächlich über die Leitung ging. Jedes einzelne Paket, mit einem Zeitstempel in Mikrosekunden-Auflösung. Ein Mitschnitt ist aber nur so gut wie seine Planung.
Wo wird der Capture gezogen?
Der Messpunkt entscheidet, was du sehen kannst. Am Client siehst du, wie lange der Anwender wirklich wartet. Am Server siehst du, wann die Anfrage dort ankommt und wie schnell er antwortet. Am aussagekräftigsten ist ein gleichzeitiger Mitschnitt an beiden Enden (Zangenmessung).
SPAN-Port oder TAP?
Ein SPAN- oder Mirror-Port spiegelt den Traffic eines Ports auf einen anderen. Das ist schnell eingerichtet und reicht für viele Analysen. Unter hoher Last kann der Switch aber Pakete verwerfen, etwa wenn beide Richtungen eines Gigabit-Ports auf einen einzelnen Gigabit-Monitorport gespiegelt werden. Fehlerhafte Frames werden meist gar nicht gespiegelt, und das Timing ist nicht immer exakt. Ein TAP (Test Access Point) sitzt direkt in der Leitung und liefert eine vollständige Kopie beider Richtungen. Wenn es um Paketverlust oder Mikrosekunden geht, ist der TAP die bessere Wahl.
Schneidest du direkt auf dem Host mit, denk an Offloading. Durch Segmentation Offload beim Senden (TSO/GSO) und Receive Offload beim Empfangen (LRO/GRO) siehst du dort Segmente, die deutlich größer als die MTU sind. Checksum Offloading sorgt zusätzlich für scheinbar falsche Prüfsummen, weil die Netzwerkkarte die Prüfsumme erst nach dem Mitschnitt berechnet. Beides gab es so auf der Leitung nie. Das ist kein Fehler im Netz, sondern ein Artefakt des Messpunkts.
Capture-Filter und Ringpuffer
Auf einem stark belasteten Link läuft die Festplatte schnell voll. Ein Capture-Filter begrenzt den Mitschnitt auf das, was du brauchst. Für einen Langzeitmitschnitt eignet sich dumpcap mit Ringpuffer, damit du das sporadische Problem nicht verpasst:
dumpcap -i 1 -f “host 10.10.20.15 and tcp port 1433” -b filesize:200000 -b files:20 -w erp_client.pcapng
Dieser Befehl schneidet nur den SQL-Server-Verkehr (TCP-Port 1433) zu einem Server mit und schreibt in rotierende Dateien von je rund 200 MB. Sobald 20 Dateien voll sind, wird jeweils die älteste überschrieben. Die passende Interface-Nummer hinter -i ermittelst du vorher mit dumpcap -D.
Aber Vorsicht: Was der Capture-Filter verwirft, ist unwiederbringlich weg. Der Filter oben zeigt dir weder DNS noch Kerberos noch eine zweite Verbindung zu einem anderen Server. Schneide den ersten Mitschnitt am Client deshalb lieber großzügig mit und grenze erst bei der Auswertung mit Display-Filtern ein. Den engen Capture-Filter brauchst du dann, wenn die Hypothese steht und du über Stunden oder Tage mitschneiden musst.
Zeitsynchronisation und Reproduktion
Wenn du an zwei Punkten misst, müssen die Uhren stimmen. Beide Messsysteme sollten per NTP synchronisiert sein. Rechne dabei aber nicht mit Mikrosekunden: Je nach System liegen NTP-synchronisierte Uhren oft nur im Bereich weniger Millisekunden beieinander. Bei einer RTT von unter einer Millisekunde reicht das nicht, um Zeitstempel aus beiden Mitschnitten direkt zu vergleichen. Dann identifizierst du dasselbe Paket in beiden Mitschnitten, etwa über TCP-Sequenznummer oder IP-ID, und gleichst den Versatz über Edit → Time Shift in Wireshark oder mit editcap -t aus. Zeitabstände innerhalb eines Mitschnitts sind davon nicht betroffen, die misst jedes System zuverlässig mit seiner eigenen Uhr.
Ebenso wichtig: Das Problem muss während des Mitschnitts auftreten. Lass den Anwender die langsame Aktion ausführen und notiere die Uhrzeit möglichst sekundengenau (hh:mm:ss). Bei Performanceproblemen brauchst du zwei Zeitstempel: den Start der Aktion, also den Klick, und das Ende, wenn die Maske vollständig geladen ist. Zwischen diesen beiden Punkten prüfst du später, was auf der Leitung passiert. Ohne diese Markierung suchst du die Nadel in einem Heuhaufen aus Millionen Paketen.
Warum Monitoring hier nicht reicht
Tools wie PRTG oder andere SNMP-basierte Lösungen sind für den Betrieb unverzichtbar. Für die Ursachenanalyse haben sie aber klare Grenzen. Sie fragen Zähler typischerweise alle paar Minuten ab und bilden Durchschnitte. Ein Microburst von 200 Millisekunden verschwindet in einem 5-Minuten-Mittelwert vollständig. Außerdem siehst du dort Interface-Auslastung, aber nicht, wie lange eine einzelne Transaktion gedauert hat. Monitoring sagt dir bestenfalls, dass etwas nicht stimmt. Der Mitschnitt sagt dir, was.
Schritt 4 – Auswerten: Hypothesen mit Paketdaten prüfen
Mit dem Mitschnitt in der Hand prüfst du jetzt deine Hypothese aus Schritt 2. Wichtig: Du suchst nicht irgendwelche Auffälligkeiten, sondern Belege für oder gegen eine konkrete Vermutung. In fast jedem Mitschnitt findest du irgendwo eine Retransmission. Entscheidend ist, ob sie mit dem Symptom zusammenhängt. Bei Performanceproblemen lautet die Prüffrage deshalb immer: Kostet dieses Ereignis messbar Zeit, und zwar genau in dem Zeitfenster, in dem der Anwender wartet? Eine Retransmission, die eine halbe Millisekunde kostet, erklärt keine 15 Sekunden Wartezeit.
Expert Info als Einstieg
Ein guter erster Blick ist Analyze → Expert Information. Wireshark sammelt dort alles, was die TCP-Analyse als auffällig markiert hat: Retransmissions, Duplicate ACKs, Out-of-Order, Zero Window. Was diese Meldungen jeweils bedeuten und warum sie oft falsch gelesen werden, erkläre ich ausführlich im Beitrag TCP Retransmissions, Dup ACKs & Out-of-Order – was die Unterschiede wirklich bedeuten.
Als Filter für alle relevanten TCP-Auffälligkeiten nutze ich:
tcp.analysis.flags and not tcp.analysis.window_update
Window Updates sind normales TCP-Verhalten und würden die Liste nur aufblähen. Deshalb blende ich sie aus. Weitere Filter, die ich in fast jeder Analyse brauche, findest du unter Wireshark – die 10 wichtigsten Display-Filter.
RTT, Retransmissions und Window Size
Die Round Trip Time (RTT) ist die Zeit, die ein Paket bis zum Ziel und die Bestätigung zurück braucht. Am verlässlichsten liest du sie am TCP-Handshake ab, weil der Server-Kernel den Handshake ohne Zutun der Anwendung beantwortet. Dabei kommt es auf den Messpunkt an: Am Client zeigt die Zeit zwischen SYN und SYN/ACK die Netzwerklaufzeit, am Server die Zeit zwischen SYN/ACK und dem abschließenden ACK. Wireshark rechnet dir die Handshake-RTT mit dem Feld tcp.analysis.initial_rtt aus, egal auf welcher Seite du mitgeschnitten hast. Wie der Verbindungsaufbau im Detail abläuft, zeige ich in TCP Handshake analysieren: SYN, SYN/ACK, ACK.
Ein Stolperstein aus der Praxis: Sitzt eine Firewall mit SYN-Proxy oder ein Load Balancer im Full-Proxy-Modus in der Strecke, beantwortet dieses Gerät den Handshake stellvertretend. Die Handshake-RTT endet dann am Proxy, nicht am Server. Spätestens hier zahlt sich deine Streckenskizze aus Schritt 2 aus. Wie du hohe Latenz sauber analysierst, zeige ich im Artikel Hohe Latenz im Firmennetz – RTT richtig analysieren.
Um Segmente mit auffällig langer Bestätigungszeit zu finden, eignet sich:
tcp.analysis.ack_rtt > 0.05
Der Filter zeigt alle Pakete, deren Bestätigung länger als 50 Millisekunden gedauert hat. Den Schwellwert passt du an deine Baseline an. Zwei Dinge solltest du dabei im Kopf behalten: Aussagekräftig für die Laufzeit ist der Wert auf der Seite, die die Daten sendet. Am Empfänger zeigt er nur, wie schnell dieser selbst bestätigt. Und nicht jede lange ACK-Zeit ist ein Netzwerkproblem. Delayed ACK, unter Windows standardmäßig bis zu 200 Millisekunden, erzeugt hohe Werte, ohne dass auf der Leitung etwas schiefläuft.
Bei Durchsatzproblemen lohnt ein Blick auf die TCP Window Size. Ist das Empfangsfenster zu klein, wartet der Sender auf Bestätigungen, obwohl die Leitung noch Kapazität hätte. Die Grundregel lautet:
Maximaler Durchsatz = TCP Window Size / Latenz (RTT)
Ein Fenster von 64 KB bei 20 ms RTT begrenzt den Durchsatz auf etwa 26 Mbit/s, egal wie schnell die Leitung ist. Heute passiert das vor allem dann, wenn Window Scaling fehlt oder unterwegs, etwa von einer Firewall, aus dem Handshake entfernt wird. Die Details dazu findest du unter TCP Window Size & Scaling einfach erklärt.
Netzwerk, Server oder Applikation?
Das ist der Kern jeder Root Cause Analysis im Netzwerk. Die Gesamtwartezeit des Anwenders setzt sich aus mehreren Anteilen zusammen:
Antwortzeit ≈ Anzahl Turns × RTT + Datenmenge / Durchsatz + Serververarbeitung + Client-Verarbeitung
Ein Turn ist ein Hin und Her zwischen Client und Server, bei dem eine Seite erst auf die Antwort der anderen wartet, bevor es weitergeht. In Wireshark trennst du die einzelnen Anteile so:
- Netzwerkverzögerung: Handshake-RTT, lange ACK-Zeiten, Retransmissions, Paketverlust, ein zu kleines Empfangsfenster. Kommen die Daten mit Lücken, Wiederholungen oder Pausen, in denen der Sender auf Bestätigungen wartet?
- Serververzögerung: Die Anfrage wird zügig auf TCP-Ebene bestätigt, aber die eigentliche Antwort kommt erst Sekunden später. Wireshark misst das bei vielen Protokollen direkt, etwa mit
http.time,dns.timeodersmb2.time. Bei TLS-verschlüsseltem Verkehr fehlen diese Felder. Dann misst du die Zeit zwischen dem letzten Paket der Anfrage und dem ersten Paket der Antwort, zum Beispiel mittcp.time_delta(dafür in den TCP-Protokolleinstellungen „Calculate conversation timestamps“ aktivieren). - Client-Verzögerung: Die Antwort ist längst da, aber der Client schickt die nächste Anfrage erst nach einer spürbaren Pause. Die Ursache liegt dann auf dem Endgerät, etwa beim Virenscanner oder in der Anwendung selbst.
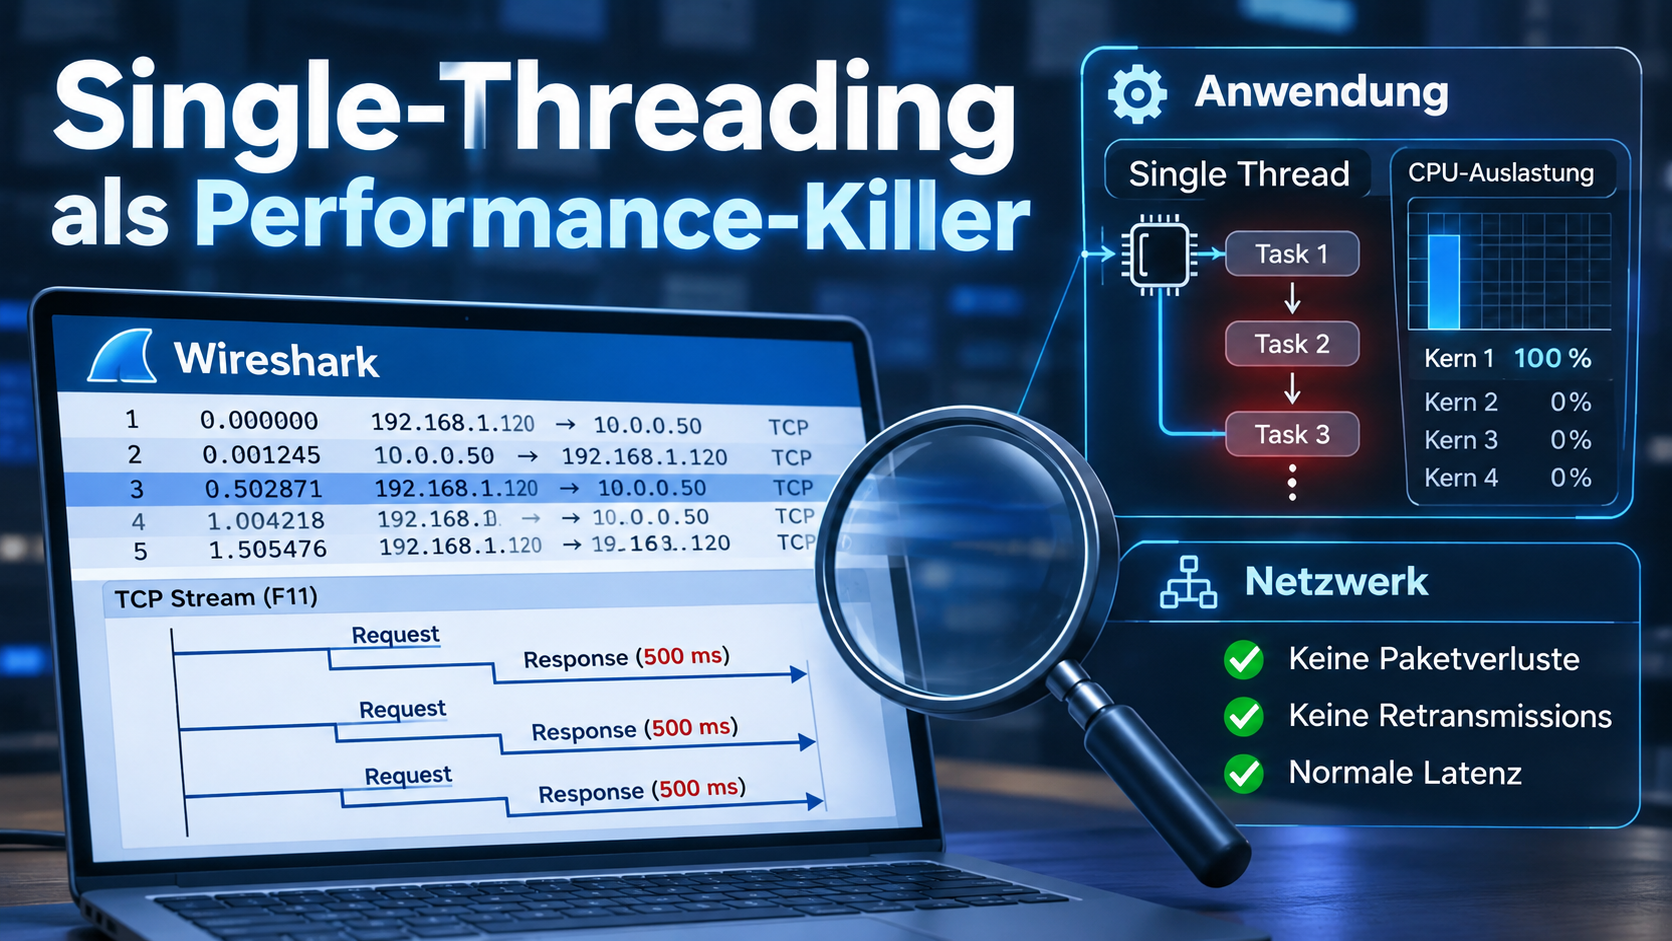
- Applikationsdesign: Netz und Server antworten schnell, aber die Anwendung schickt hunderte kleine Anfragen nacheinander. Jede einzelne ist harmlos, in der Summe dauert es ewig. Das ist der Faktor Turns × RTT aus der Formel, und genau den siehst du gleich im Praxisbeispiel. Ähnlich wirkt es, wenn eine Anwendung ihre Arbeit strikt nacheinander abarbeitet, siehe Single-Threading als Performance-Killer.
Einzelne Verbindungen im Detail
Hast du die verdächtige Verbindung gefunden, folgst du ihr per Follow TCP Stream oder filterst auf den Stream-Index, zum Beispiel mit tcp.stream eq 12. Erst in der zeitlichen Abfolge wird sichtbar, wer auf wen wartet. Worauf ich dabei achte, steht im Beitrag Wie lese ich einen TCP Stream richtig?
Schritt 5 – Ergebnis dokumentieren und Maßnahmen ableiten
Eine Analyse, die nur im Kopf des Analysten existiert, ändert nichts. Das Ergebnis muss so aufbereitet sein, dass beide Teams die Beweisführung nachvollziehen können, auch diejenigen, die selbst nie Wireshark öffnen. Für die IT-Leitung ist dieser Bericht oft die eigentliche Entscheidungsgrundlage: Er zeigt, wofür Budget sinnvoll ist und wofür nicht.
Meine Dokumentation folgt immer derselben Struktur:
- Ausgangslage: das messbare Symptom aus Schritt 1, inklusive Baseline.
- Messaufbau: wo, wann und womit mitgeschnitten wurde.
- Befund: konkrete Zahlen, Paketnummern, Zeitstempel, Screenshots. Keine Interpretation ohne Beleg.
- Schlussfolgerung: Wo entsteht die Verzögerung, und wo entsteht sie nachweislich nicht?
- Maßnahme und Verantwortlicher: Was wird geändert, und wer setzt es um?
- Erfolgskontrolle: erneute Messung nach der Änderung, unter denselben Bedingungen.
Der letzte Punkt wird am häufigsten vergessen. Ohne zweite Messung weißt du nicht, ob die Maßnahme gewirkt hat oder ob das Problem nur gerade nicht auftritt. Und genauso wichtig wie die Schuldfrage ist die Entlastung: Ein Bericht, der klar zeigt, dass das Netz unbeteiligt ist, beendet Diskussionen oft schneller als jede Maßnahme.
Die 5 Schritte auf einen Blick
| Schritt | Leitfrage | Werkzeug | Ergebnis |
|---|---|---|---|
| 1. Problem definieren | Wer, was, wann, wo, reproduzierbar? | Gespräch, Stoppuhr, Change-Log, Ticketverlauf | Messbares Symptom mit Baseline |
| 2. Schicht und Strecke eingrenzen | Was funktioniert, was nicht? | Streckenskizze, Vergleichsclient, OSI-Modell | Hypothese mit begrenztem Suchraum |
| 3. Beweise sammeln | Wo und wie messe ich? | Wireshark, dumpcap, TAP oder SPAN, NTP |
Mitschnitt während des Fehlers |
| 4. Auswerten | Stimmt die Hypothese? | Expert Info, Display-Filter, Stream-Analyse | Belegte Ursache: Netz, Server, Client oder Applikation |
| 5. Dokumentieren | Was ändern wir, und hat es gewirkt? | Bericht, erneute Messung | Maßnahme mit Erfolgsnachweis |
Typische Fehler bei der Eingrenzung
Auch mit Methodik passieren immer wieder dieselben Fehler. Die meisten kosten nicht nur Zeit, sondern führen zu falschen Schlüssen:
- Capture am falschen Punkt: Wer nur am Server misst, sieht nicht, was der Client erlebt. DNS- oder Kerberos-Probleme des Clients sind am Server gar nicht erkennbar.
- Zu spät gestartet: Der Mitschnitt läuft erst, nachdem die Verbindung aufgebaut wurde. Damit fehlt der TCP-Handshake und mit ihm die RTT, die Window-Scaling-Faktoren und die MSS. Ohne Skalierungsfaktor kann Wireshark die tatsächliche Fenstergröße nicht berechnen und zeigt dir falsche Werte an.
- Nur ein Messpunkt: Mit einem einzigen Mitschnitt lässt sich oft nicht sagen, ob die Verzögerung in der Strecke oder im Endpunkt entsteht.
- Ping als Beweis: „Der Ping ist grün“ beweist nur, dass ICMP-Pakete durchkommen. Viele Geräte behandeln ICMP anders als Nutzdaten, und ein paar Pings im Sekundentakt erwischen keine kurzen Verluste durch Lastspitzen oder Microbursts. Warum das so ist, liest du im Artikel Packet Loss messen – warum Pings oft lügen.
- Änderungen während der Analyse: Wenn parallel jemand „nur kurz“ eine Firewall-Regel anpasst oder einen Treiber aktualisiert, sind deine Messungen nicht mehr vergleichbar. Friere die Umgebung für die Dauer der Analyse ein, so gut es geht.
Praxisbeispiel: Wenn das Netz unschuldig ist
Ein typischer Fall aus meiner Praxis, ohne Kundenbezug: Ein mittelständisches Unternehmen mit Zentrale und drei Außenstandorten. Die Mitarbeiter in einer Niederlassung klagen seit Wochen über ein langsames Warenwirtschaftssystem. Das Netzwerkteam hat die MPLS-Leitung bereits einmal aufrüsten lassen. Ohne Effekt.
Schritt 1: Wir definieren das Symptom. Das Öffnen der Auftragsübersicht dauert in der Niederlassung 18 Sekunden, in der Zentrale 3 Sekunden. Das ist jederzeit reproduzierbar, unabhängig von der Tageszeit.
Schritt 2: Ein zweiter Client in der Niederlassung zeigt denselben Wert. Andere Anwendungen am Standort, etwa Dateizugriffe und Webanwendungen, laufen normal. Die Leitung ist nicht ausgelastet. Hypothese: Das Problem hängt mit der Laufzeit zur Zentrale zusammen, nicht mit der Bandbreite.
Schritt 3: Wir schneiden gleichzeitig am Client in der Niederlassung und am Datenbankserver in der Zentrale mit. Beide Systeme sind per NTP synchronisiert, der Anwender öffnet die Auftragsübersicht dreimal hintereinander, die Uhrzeiten werden notiert.
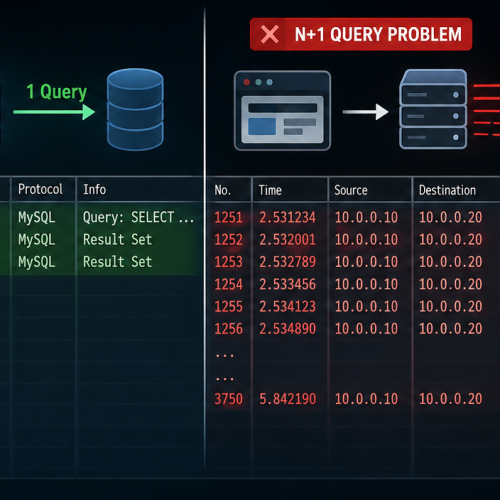
Schritt 4: Der Mitschnitt zeigt keine Retransmissions, keinen Paketverlust, kein volles Empfangsfenster. Aber die Anwendung schickt für eine einzige Ansicht rund 1.800 SQL-Abfragen nacheinander. Jede wartet auf die Antwort der vorherigen. Der Server beantwortet jede Abfrage in etwa einer Millisekunde. Die RTT zur Niederlassung liegt bei 9 Millisekunden, in der Zentrale bei unter einer.
Wartezeit ≈ 1.800 Turns × (9 ms RTT + 1 ms Server) ≈ 18 Sekunden
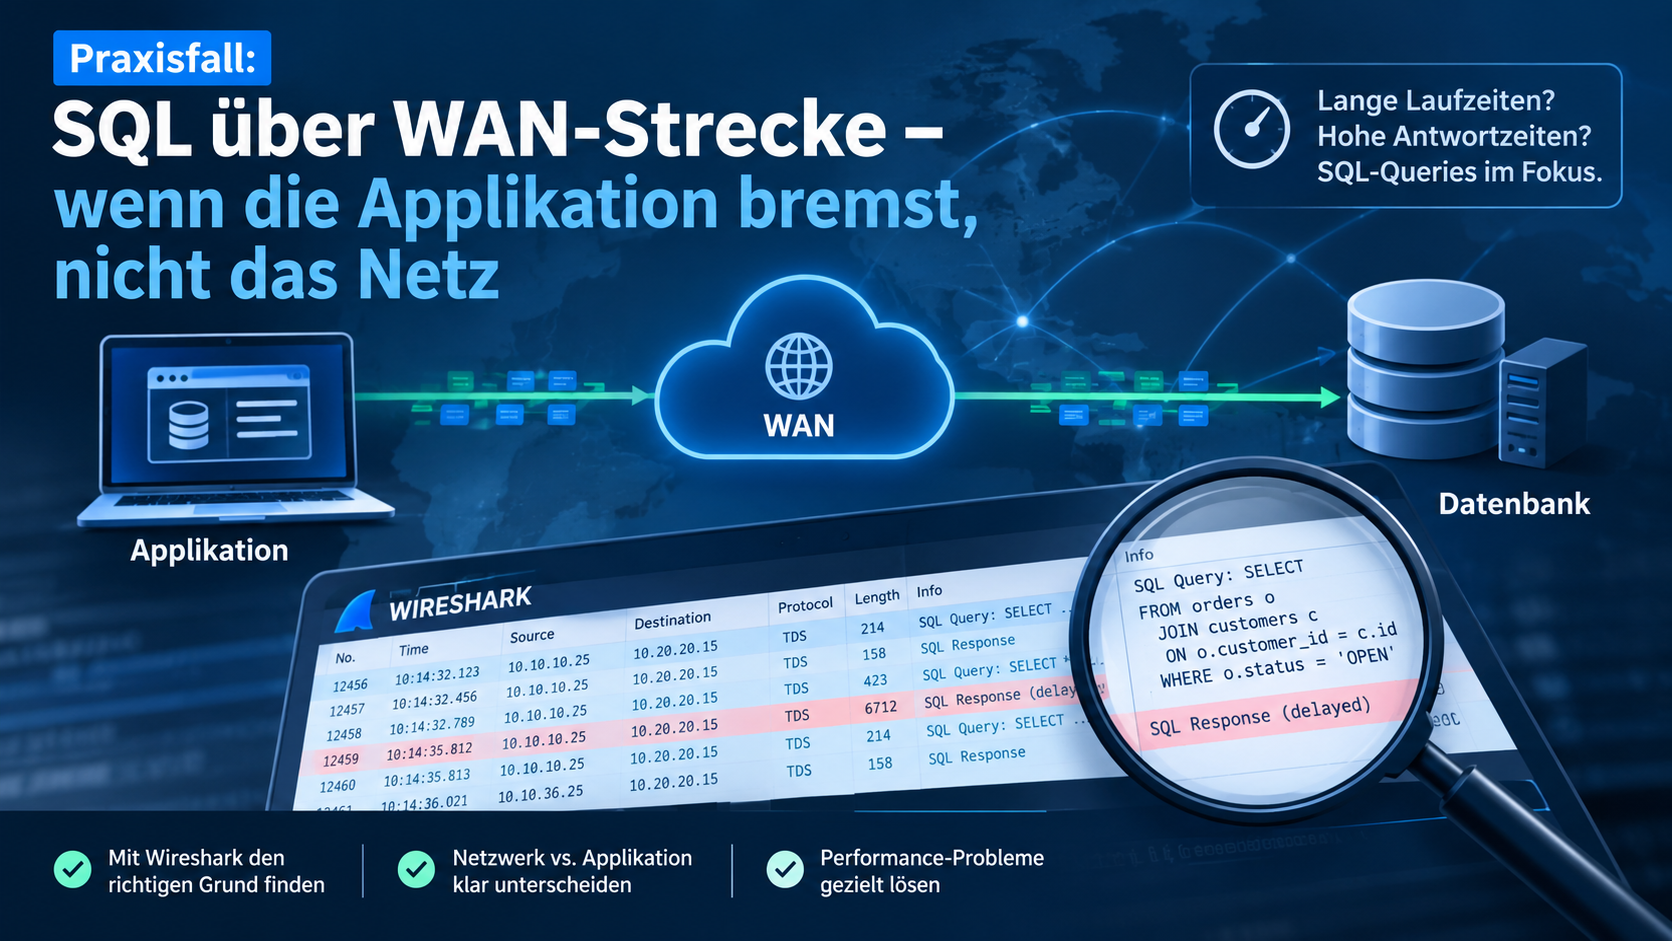
Das deckt sich mit den gemessenen 18 Sekunden. Die Gegenprobe in der Zentrale: 1.800 × (unter 1 ms + 1 ms) ergibt knapp 3 Sekunden, also genau den dort gemessenen Wert. Wenn die Rechnung an beiden Standorten aufgeht, ist die Ursache belegt: eine sehr gesprächige Anwendung, kein Netzwerkfehler. Keine Leitung der Welt macht aus 9 Millisekunden Lichtlaufzeit und Routing 0 Millisekunden. Einen ganz ähnlichen Fall habe ich ausführlich im Praxisfall: Sequentielle DB-Requests & N+1 Query beschrieben, ein weiteres Beispiel findest du im Praxisfall: SQL über WAN-Strecke.
Schritt 5: Der Bericht ging an beide Teams und an den Softwarehersteller. Kurzfristig arbeitet die Niederlassung über einen Terminalserver in der Zentrale, direkt neben der Datenbank. Die erneute Messung ergab 2,5 Sekunden. Mittelfristig bündelt der Hersteller die Abfragen. Und die zusätzliche Bandbreite? Die hätte man sich sparen können. Das Problem ist nicht die Bandbreite, sondern die Laufzeit (RTT), multipliziert mit der Anzahl der Abfragen.
Wann lohnt sich externe Unterstützung?
Viele Probleme lassen sich mit dieser Methodik intern lösen. Und das ist auch gut so. Es gibt aber Situationen, in denen ein externer Blick sinnvoll ist:
- Das Problem besteht seit Wochen, und mehrere Maßnahmen haben nichts gebracht.
- Die Teams haben sich festgefahren, und jede neue Messung wird von der Gegenseite angezweifelt.
- Es fehlt die Zeit oder die Erfahrung, Mitschnitte auf Paketebene sauber auszuwerten.
- Mehrere Parteien sind beteiligt, etwa Provider, Softwarehersteller und interne IT, und jede sieht die Ursache bei den anderen.
Ein externer Analyst hat in dieser Konstellation einen Vorteil, der nichts mit Technik zu tun hat: Er hat kein eigenes System zu verteidigen. Mein Ansatz lautet deshalb „Forensik statt Fingerpointing“. Ich messe, werte aus und lege die Beweise so auf den Tisch, dass Netzwerk- und Applikationsteam auf dieselbe Faktenlage schauen. Danach geht es meistens nicht mehr um die Frage, wer schuld ist, sondern nur noch darum, was als Nächstes zu tun ist.
Egal ob du aus dem Netzwerkteam, aus dem Applikationsbetrieb oder aus der IT-Leitung kommst: Wenn sich bei euch gerade alle im Kreis drehen, schreib mir über das Kontaktformular eine kurze Beschreibung der Situation. Im kostenlosen Erstgespräch schätzen wir gemeinsam ein, wo der nächste sinnvolle Messpunkt liegt.