TCP Congestion Control: Reno, CUBIC und BBR im Vergleich – und wie du sie im Wireshark-Trace erkennst
Inhaltsverzeichnis
ToggleWas ist TCP Congestion Control – und warum ist es wichtig?
TCP ist ein zuverlässiges Protokoll: Es sorgt dafür, dass Daten vollständig und in der richtigen Reihenfolge ankommen. Zuverlässigkeit allein reicht aber nicht. Würde jeder TCP-Sender so schnell senden, wie er kann, würden Netzwerke sofort kollabieren. Genau hier kommt Congestion Control ins Spiel. Das Grundprinzip: TCP verwaltet intern ein Congestion Window (CWND) – eine dynamische Obergrenze dafür, wie viele unbestätigte Daten gleichzeitig „im Flug“ sein dürfen. Dieses Fenster wird laufend angepasst, je nachdem, wie das Netzwerk reagiert. Wie viel tatsächlich unterwegs ist, bestimmt immer das kleinere von zwei Fenstern: das CWND, mit dem der Sender das Netz einschätzt, und das Receive Window, das der Empfänger ankündigt. Wie beide zusammenspielen, erkläre ich ausführlich im Artikel TCP Window Size & Scaling einfach erklärt. Ein Punkt, der in der Praxis oft übersehen wird: Congestion Control ist reine Sendersache. Der Empfänger hat darauf keinen Einfluss. Wenn ein Client eine Datei vom Fileserver lädt, zählt der Algorithmus des Servers – nicht der des Clients.Slow Start
Zu Beginn einer Verbindung kennt TCP die verfügbare Bandbreite nicht. Es startet deshalb mit einem kleinen CWND – auf aktuellen Linux- und Windows-Systemen sind das 10 Segmente, also rund 14 KB – und verdoppelt es ungefähr pro Round Trip, solange keine Verluste auftreten. Das ist ein exponentieller Anstieg – trotzdem verbringen kurze Verbindungen wie einzelne HTTP-Requests einen großen Teil ihrer Lebenszeit im Slow Start.
Praxisrelevant ist außerdem der Slow Start nach Leerlauf: Linux verkleinert das CWND standardmäßig wieder, wenn eine Verbindung länger als einen Retransmission Timeout lang nichts gesendet hat (Parameter net.ipv4.tcp_slow_start_after_idle). Langlebige Verbindungen mit sporadischen Datenschüben – etwa zwischen Applikationsserver und Datenbank – starten dann über WAN jedes Mal wieder klein.
Congestion Avoidance und AIMD
Sobald das CWND einen Schwellwert erreicht (Slow Start Threshold, kurz ssthresh), wechselt TCP in die Congestion Avoidance: Das Fenster wächst nur noch linear, um etwa ein Segment pro RTT. Erkennt TCP ein Überlastungssignal – klassisch einen Paketverlust –, wird das Fenster deutlich verkleinert. Dieses Prinzip heißt Additive Increase, Multiplicative Decrease (AIMD) und ist das Fundament aller klassischen Algorithmen.
Warum das für dich relevant ist: Wie ein Algorithmus diesen Zyklus umsetzt, entscheidet, wie schnell deine Verbindung nach einem Einbruch wieder auf Touren kommt. Auf einer LAN-Strecke mit 1 ms RTT merkst du davon kaum etwas. Auf einer WAN-Verbindung mit 80 ms RTT kann es dagegen den Unterschied zwischen 50 Mbit/s und 500 Mbit/s ausmachen – bei identischer physischer Bandbreite.
TCP Reno – der Klassiker unter den Congestion-Algorithmen
TCP Reno ist alt. Sehr alt. Seine Grundlagen entstanden Ende der 1980er Jahre, und Reno beziehungsweise sein Nachfolger NewReno war über viele Jahre der Standard in nahezu allen TCP-Stacks. Heute begegnet er dir noch in älteren Systemen, in Appliances und Embedded-Geräten – und unter Windows im TCP-Profil „Compat“. Er funktioniert, solange die Randbedingungen stimmen.
Funktionsprinzip
Reno arbeitet rein verlustbasiert: Paketverlust ist das einzige Signal, an dem er Überlastung erkennt. Kommen drei doppelte ACKs an, sendet Reno das fehlende Segment sofort neu (Fast Retransmit) und halbiert das CWND (Fast Recovery). Bei einem Retransmission Timeout – dem härteren Verlustereignis – fällt das Fenster sogar auf ein Segment zurück, und TCP beginnt wieder mit Slow Start. Danach wächst das Fenster linear.
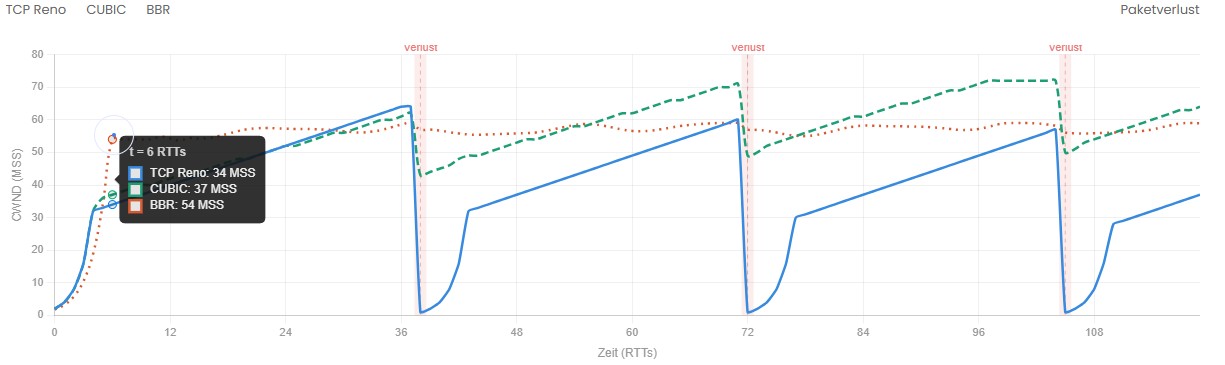
Das Ergebnis ist das bekannte Sägezahnmuster (Sawtooth Pattern): Das CWND wächst stetig, bricht abrupt ein und wächst wieder. Dieses Muster kannst du im Wireshark-Trace sichtbar machen – dazu gleich mehr.
Wo Reno an Grenzen stößt
Das Kernproblem von Reno ist das Bandwidth-Delay-Product (BDP): Bei hoher Bandbreite und hoher Latenz muss das CWND sehr groß werden, um die Leitung auszulasten. Ein Rechenbeispiel macht das greifbar: Bei 1 Gbit/s und 80 ms RTT liegt das BDP bei 10 MB, also rund 6.850 Segmenten. Nach einem einzigen Verlust halbiert Reno auf etwa 3.425 Segmente – und baut dann ein Segment pro RTT wieder auf. Bis die Leitung wieder voll ist, vergehen 3.425 Round Trips, also rund viereinhalb Minuten. Kommt in dieser Zeit ein zweiter Verlust dazu, erreicht Reno die volle Bandbreite nie.
Wie stark schon kleine Verlustraten den Durchsatz begrenzen, zeigt die Faustformel von Mathis et al. für AIMD-basiertes TCP:
Maximaler Durchsatz ≈ (MSS / RTT) × (1,22 / √Verlustrate)
Mit 1.460 Byte MSS, 80 ms RTT und gerade einmal 0,01 % Paketverlust landest du bei etwa 18 Mbit/s – egal, ob die Leitung 100 Mbit/s oder 10 Gbit/s hat. Bei 0,1 % Verlust sind es noch knapp 6 Mbit/s. Deshalb ist es so wichtig, auch scheinbar unbedeutenden Verlust ernst zu nehmen und richtig zu messen. Wie das geht, zeige ich in Packet Loss messen – warum Pings oft lügen.
In einem Projekt bei einem Industriekunden mit 10-Gbit/s-Backbone und mehreren Standortverbindungen mit 30–60 ms Latenz haben wir genau dieses Phänomen beobachtet: Der Durchsatz beim File-Transfer lag bei unter 10 % der theoretischen Kapazität – nicht wegen der Hardware, sondern weil die beteiligten Systeme noch mit Reno arbeiteten und sich nach jedem Verlust nur im Schneckentempo erholten.
CUBIC – der Standard unter Linux und Windows
CUBIC ist seit Linux-Kernel 2.6.19 (2006) der Standard-Algorithmus unter Linux und damit auf dem Großteil der Server im Einsatz. Microsoft hat nachgezogen: Seit Windows 10 (Version 1709) und Windows Server 2019 ist CUBIC auch dort Standard, vorher setzte Windows Server auf Compound TCP. CUBIC wurde entwickelt, um genau das Problem zu lösen, das Reno auf schnellen, langen Strecken hat.
Das kubische Wachstum
Nach einem Verlust reduziert CUBIC das Fenster nicht auf die Hälfte, sondern nur auf 70 %. Danach wächst es entlang einer kubischen Funktion, die sich am Fenster vor dem Verlust orientiert (Wmax). Zuerst steigt das Fenster schnell, wird in der Nähe von Wmax langsamer – denn dort gab es zuletzt Probleme – und beschleunigt wieder, wenn dort kein neuer Verlust auftritt. So tastet sich CUBIC vorsichtig über das alte Maximum hinaus.
Der entscheidende Unterschied: CUBIC baut das Fenster zeitbasiert auf – abhängig von der Zeit seit dem letzten Verlust, nicht von der Anzahl der Round Trips. Dadurch erholen sich Verbindungen mit langer RTT deutlich schneller als bei Reno, und Flows mit unterschiedlicher Latenz teilen sich einen Engpass fairer. Auf Strecken mit kleinem BDP schaltet CUBIC übrigens in einen Reno-ähnlichen Modus (die sogenannte TCP-friendly Region). Dort verhalten sich beide praktisch gleich.
Stärken und Schwächen von CUBIC
Stärken: Sehr gute Auslastung schneller Leitungen bis in den 10G- und 100G-Bereich, schnellere Erholung nach Verlust, fairer gegenüber Verbindungen mit langer RTT, gut erforscht und seit vielen Jahren stabil im Einsatz.
Schwächen: CUBIC ist weiterhin verlustbasiert. Es reagiert auf jeden Verlust – auch auf Verlust, der gar nicht durch Überlastung entsteht, sondern durch die Leitung selbst: WLAN, Mobilfunk, Satellit, eine defekte Optik oder ein Duplex-Mismatch. Auf solchen Strecken drosselt sich CUBIC unnötig. Der zweite, im Alltag oft unterschätzte Effekt: CUBIC füllt die Puffer. Es vergrößert das Fenster so lange, bis irgendwo ein Puffer überläuft. Bis dahin steigt die Latenz für alle, die dieselbe Leitung nutzen. Das ist das klassische Bufferbloat-Szenario: Ein großer Dateitransfer läuft, und plötzlich ruckeln die Citrix-Sitzungen und die VoIP-Telefonate am selben Standort.
BBR – Googles Ansatz: modellbasiert statt verlustbasiert
BBR (Bottleneck Bandwidth and Round-trip propagation time) wurde von Google entwickelt, 2016 veröffentlicht und ist seit Kernel 4.9 Teil von Linux. Es ist ein Paradigmenwechsel: Statt auf Paketverlust zu warten, versucht BBR, den Engpass der Strecke aktiv zu vermessen.
Wie BBR das Netz modelliert
BBR misst laufend zwei Größen: die maximal beobachtete Bandbreite am Engpass (BtlBw) und die minimal beobachtete RTT (RTprop). Das Produkt aus beiden ist das BDP – genau die Datenmenge, die nötig ist, um die Leitung zu füllen, ohne eine Warteschlange aufzubauen. Gesteuert wird BBR dabei in erster Linie über die Pacing-Rate, also einen gleichmäßigen Sendetakt. Das CWND ist nur noch eine Obergrenze, in der Regel das Doppelte des geschätzten BDP.
Im Betrieb durchläuft BBR mehrere Phasen. Im Startup verdoppelt er die Rate pro Round Trip, bis die gemessene Bandbreite nicht mehr steigt. Im Drain baut er die dabei entstandene Warteschlange wieder ab. Danach folgt die Dauerphase ProbeBW: In kurzen Zyklen sendet BBR etwas schneller, um zusätzliche Bandbreite zu entdecken, und gleich danach etwas langsamer, um die Queue wieder zu leeren. Hat BBR rund zehn Sekunden lang keine niedrigere RTT gemessen, folgt ProbeRTT: Für etwa 200 ms reduziert er die Daten im Flug auf vier Pakete, um die echte Basis-RTT neu zu bestimmen.
BBR kennt deshalb kein klassisches Sägezahnmuster. Ein einzelner Verlust auf einer schlechten WLAN- oder Mobilfunkstrecke führt nicht automatisch zur Drosselung. Das zeigt sehr schön, warum Paketverlust allein kein zuverlässiges Überlastungssignal ist. Welche Verlustsignale TCP überhaupt kennt und wie sie sich unterscheiden, erkläre ich in TCP Retransmissions, Dup ACKs & Out-of-Order – Unterschiede.
BBR in der Praxis: WAN und Cloud
In Cloud-Umgebungen, auf WAN-Strecken mit hoher Latenz und auf Verbindungen mit gelegentlichem Verlust, der nicht durch Überlastung entsteht, spielt BBR seine Stärken aus. Google hat die Ergebnisse veröffentlicht: Im eigenen Backbone zwischen den Rechenzentren lag der Durchsatz um den Faktor 2 bis 25 über CUBIC. Bei YouTube stand dagegen die Latenz im Vordergrund: Die mediane RTT sank im weltweiten Schnitt um 53 %, in Regionen mit schwächerer Infrastruktur um mehr als 80 %, während der Durchsatz nur um einige Prozent zulegte. Das sind allerdings Google-Strecken mit Google-Traffic – ob BBR in deinem Netz etwas bringt, zeigt nur eine saubere Vorher-Nachher-Messung.
Fairness, Retransmissions und Versionen
Hier wird es kritisch: BBR und CUBIC spielen nicht immer gut zusammen. Teilen sich BBR- und CUBIC-Flows denselben Engpass, hängt die Verteilung stark von der Puffergröße ab. Bei flachen Puffern verdrängt BBR die verlustbasierten Flows oft deutlich. Bei sehr tiefen Puffern kann es umgekehrt sein, weil CUBIC die Queue füllt, während BBR seine Rate am Modell ausrichtet. In homogenen Umgebungen ist das kein Thema – sobald aber gemischte Systeme denselben Upstream nutzen, solltest du genau hinschauen.
Ein zweiter Punkt, der im Trace auffällt: Die ursprüngliche Version BBRv1 ignoriert Verlust weitgehend. Auf Strecken mit flachen Puffern kann das zu dauerhaft hohen Retransmission-Raten führen, obwohl der Durchsatz gut aussieht. Google hat mit BBRv2 und BBRv3 nachgebessert: Diese Versionen reagieren ab einer bestimmten Verlustrate und auf ECN-Markierungen. Unter Linux steht hinter der Einstellung bbr in den meisten Distributionen aber noch die erste Version – prüfe das für deinen Kernel. Neuere Windows-11-Versionen bieten BBR2 optional als Congestion Provider an.
Direkter Vergleich: Reno vs. CUBIC vs. BBR – wann lohnt sich was?
| Algorithmus | Ansatz | Reaktion auf Verlust | Typischer Einsatz | Stärke | Schwäche |
|---|---|---|---|---|---|
| TCP Reno / NewReno | Verlustbasiert, lineares AIMD | CWND wird halbiert, bei Timeout zurück auf 1 Segment | Legacy-Systeme, Appliances, Embedded | Einfach, gut verstanden, fair bei gleicher RTT | Sehr langsame Erholung bei hohem BDP, benachteiligt Verbindungen mit langer RTT |
| CUBIC | Verlustbasiert, kubisches, zeitbasiertes Wachstum | CWND wird auf 70 % reduziert | Standard unter Linux (seit 2006) und Windows (seit Windows 10 1709 / Server 2019) | Hohe Auslastung schneller Leitungen, RTT-fairer als Reno | Reagiert auf nicht-kongestiven Verlust, füllt Puffer (Bufferbloat) |
| BBR | Modellbasiert (BtlBw + RTprop), Pacing | v1 kaum, v2/v3 ab bestimmter Verlustrate und auf ECN | Cloud, CDN, WAN mit hoher Latenz, Mobilfunk | Hoher Durchsatz trotz Zufallsverlust, kurze Warteschlangen | Fairness gegenüber CUBIC abhängig von Puffergröße, hohe Retransmission-Raten bei flachen Puffern (v1) |
Eine einfache Faustregel: Auf Linux- und Windows-Servern in homogenen Umgebungen ist CUBIC der richtige Standard – es gibt selten einen Grund, ihn ohne Messung zu ändern. Für Server, die große Datenmengen über WAN-Strecken mit hoher Latenz oder über verlustbehaftete Leitungen ausliefern, lohnt sich ein Test mit BBR – aber nur auf dem sendenden System und nur, wenn du die Auswirkungen auf andere Flows im Blick behältst. Reno gehört in den meisten Szenarien der Vergangenheit an. Wenn du ihn noch findest, ist das meist ein Hinweis auf veraltete Systeme.
Schematische Darstellung, nicht maßstabsgetreu. Werte oberhalb der BDP-Linie liegen als Warteschlange im Puffer.
TCP Reno
Sägezahnmuster
Halbiert bei Verlust, linearer Wiederaufbau – auf WAN-Strecken sehr langsam
CUBIC
Kubische Kurve
Reduziert auf 70 %, schnell zurück zum alten Maximum, dann vorsichtiges Plateau – füllt Puffer
BBR
Stabil um das BDP
Ignoriert Einzelverluste, kurze Probe-Spitzen, deutlicher Einbruch nur bei ProbeRTT
Was du im Wireshark-Trace siehst – Congestion Control erkennbar machen
Den Algorithmus selbst siehst du im Trace nicht direkt – sein Verhaltensmuster aber sehr wohl.
Vorab: am richtigen Ende mitschneiden
Für die Analyse von Congestion Control ist der Capture-Punkt entscheidend. Wireshark kann das CWND nicht direkt sehen, berechnet aber aus Sequenz- und ACK-Nummern die Bytes in Flight – also gesendete, noch nicht bestätigte Daten. Das ist die beste Annäherung an das tatsächlich genutzte Fenster, aber nur dann aussagekräftig, wenn du möglichst nah am Sender mitschneidest. Ein Trace auf Empfängerseite zeigt dir zwar Verluste und Lücken, verzerrt aber Bytes in Flight und RTT-Werte. Wie du einen Stream grundsätzlich liest, erkläre ich in Wie lese ich einen TCP Stream richtig?
Das Sägezahnmuster sichtbar machen: Bytes in Flight im I/O-Graph
Öffne Statistics → I/O Graphs, lege einen neuen Graphen an und setze als Display-Filter den Stream, den du untersuchst, zum Beispiel tcp.stream eq 3. Als Y-Feld trägst du tcp.analysis.bytes_in_flight ein, als Berechnung MAX(Y Field) und als Intervall 100 ms. Jetzt siehst du die Kurve, die im Diagramm oben schematisch dargestellt ist:
- Reno und CUBIC: Die Kurve steigt, bricht nach einem Verlust ein und steigt wieder – das Sägezahnmuster. Bei CUBIC ist der Einbruch flacher, und du erkennst das typische Plateau kurz unterhalb des alten Maximums.
- BBR: Die Kurve pendelt eng um einen Wert, mit kleinen regelmäßigen Spitzen aus den ProbeBW-Zyklen. Ein kurzer, tiefer Einbruch etwa alle zehn Sekunden ist kein Fehler, sondern ProbeRTT.
- Flache Linie weit unter dem BDP, ohne Verluste: Hier bremst nicht die Congestion Control, sondern etwas anderes – dazu weiter unten mehr.
Time/Sequence-Graph (tcptrace)
Unter Statistics → TCP Stream Graphs → Time Sequence (tcptrace) siehst du die gesendeten Sequenznummern über die Zeit. Die Steigung der Kurve entspricht dem Durchsatz. Bei verlustbasierten Algorithmen wird sie nach jedem Verlust flacher und richtet sich danach langsam wieder auf. Retransmissions erkennst du als Segmente, die unterhalb der bisherigen Linie erneut gesendet werden. Läuft die Datenlinie dagegen regelmäßig an die obere Linie – das Receive Window des Empfängers – und bleibt dort hängen, limitiert der Empfänger, nicht das Netz.
RTT-Verlauf: Bufferbloat erkennen
Der Graph unter Statistics → TCP Stream Graphs → Round Trip Time zeigt, wie sich die Latenz während der Übertragung entwickelt. Vergleiche die RTT unter Last mit der RTT im Leerlauf, die du zum Beispiel aus dem TCP Handshake ablesen kannst. Steigt die RTT unter Last deutlich über den Leerlaufwert und fällt nach Retransmissions schlagartig ab, laufen Puffer voll – klassisches Bufferbloat, typisch für CUBIC auf Strecken mit großen Puffern. Bei BBR bleibt die RTT in der Regel näher am Basiswert. Wie du RTT-Werte sauber interpretierst, zeige ich ausführlich in Hohe Latenz im Firmennetz – RTT analysieren.
Retransmissions und doppelte ACKs filtern
Um die Verlustereignisse zu isolieren, die einen Einbruch auslösen, filterst du auf Retransmissions:
tcp.analysis.retransmission or tcp.analysis.fast_retransmission
Und für doppelte ACKs, die auf Verlust oder Umsortierung hinweisen:
tcp.analysis.duplicate_ack
Mehr zur Interpretation dieser Signale findest du in TCP Retransmissions: Der stille Performance-Killer.
Auswertung auf der Kommandozeile mit tshark
Für große Traces oder wiederholbare Auswertungen ist tshark praktischer als die GUI. Mit der Statistikfunktion io,stat bekommst du die maximalen Bytes in Flight und die Anzahl der Retransmissions pro 100-ms-Intervall – ideal, um Einbrüche und Verluste zeitlich zu korrelieren:
tshark -r trace.pcapng -q -z "io,stat,0.1,MAX(tcp.analysis.bytes_in_flight)tcp.stream==3 && tcp.analysis.bytes_in_flight,COUNT(tcp.analysis.retransmission)tcp.stream==3 && tcp.analysis.retransmission"
Dateiname und Stream-Nummer passt du an deinen Trace an. So siehst du, ob Einbrüche mit Retransmissions zusammenfallen und wie lange die Erholung dauert.
Den aktiven Algorithmus ermitteln und ändern
Linux
Den systemweit aktiven Algorithmus fragst du so ab:
sysctl net.ipv4.tcp_congestion_control
Welche Algorithmen der Kernel aktuell anbietet, zeigt dir dieser Befehl:
sysctl net.ipv4.tcp_available_congestion_control
Fehlt BBR in der Liste, lädst du das Kernelmodul nach:
sudo modprobe tcp_bbr
Besonders nützlich für die Analyse: Mit ss siehst du pro Verbindung, welcher Algorithmus läuft – dazu live CWND, RTT und Retransmissions. Die IP-Adresse ersetzt du durch die Gegenstelle:
ss -tin dst 192.0.2.10
Zum Testen stellst du den Algorithmus zur Laufzeit um. Die Änderung gilt nur für neue Verbindungen und ist nach einem Neustart wieder weg:
sudo sysctl -w net.ipv4.tcp_congestion_control=bbr
Soll BBR dauerhaft aktiv sein, schreibst du die Einstellung in eine eigene Datei unter /etc/sysctl.d/. Den Paket-Scheduler fq setzt du gleich mit, weil er das Pacing effizient übernimmt, auf das BBR setzt (Kernel vor 4.13 brauchen ihn zwingend):
printf "net.core.default_qdisc=fq\nnet.ipv4.tcp_congestion_control=bbr\n" | sudo tee /etc/sysctl.d/90-tcp-bbr.conf && sudo sysctl --system
Windows
Unter Windows ist der Congestion Provider pro TCP-Profil hinterlegt. In einer PowerShell siehst du ihn so:
Get-NetTCPSetting | Select-Object SettingName, CongestionProvider
Alternativ zeigt dir netsh das aktive Standardprofil inklusive Congestion Provider:
netsh int tcp show supplemental
Ganz gleich, auf welchem System: Ändere den Algorithmus nie blind auf allen Servern. Teste ihn auf einem System, schneide vorher und nachher mit und vergleiche Durchsatz, RTT und Retransmission-Rate. Nur so weißt du, ob die Änderung etwas bringt – und ob sie anderen Verkehr verdrängt.
Das Bandwidth-Delay-Product als Referenz
Um einzuordnen, ob ein beobachteter Durchsatz überhaupt erreichbar ist, hilft das BDP:
BDP = Bandbreite (bit/s) × RTT (s)
Ein Beispiel: 1 Gbit/s und 80 ms RTT ergeben 80 Mbit, also 10 MB. So viele Daten müssen gleichzeitig unterwegs sein, um die Leitung voll auszulasten. Liegen die Bytes in Flight in deinem Trace dauerhaft weit darunter, kann die Leitung schlicht nicht ausgelastet werden – und die spannende Frage ist, wer das Fenster klein hält.
Bevor du am Algorithmus drehst: Ist es wirklich Congestion Control?
Nicht jedes Durchsatzproblem auf einer WAN-Strecke ist ein Congestion-Control-Problem. Bevor du Kernel-Parameter änderst, prüfe im Trace, welches Muster du tatsächlich vor dir hast:
- Window Full oder Zero Window: Meldet Wireshark
tcp.analysis.window_fullodertcp.analysis.zero_window, limitiert der Empfänger. Ursache ist oft ein zu kleiner Empfangspuffer oder Window Scaling, das unterwegs verloren geht – kein Fall für BBR. - Bytes in Flight weit unter dem BDP, keine Verluste: Die Applikation schickt schlicht nicht genug Daten am Stück, etwa weil sie im Request-Response-Takt arbeitet. Typisch für Datenbankzugriffe über WAN – siehe Praxisfall: SQL über WAN-Strecke und Praxisfall: Sequentielle DB-Requests & N+1 Query.
- Retransmissions mit steigender RTT unter Last: Puffer laufen voll – das ist klassisches Congestion-Control-Terrain. Hier können ein Algorithmuswechsel oder ein besseres Queue-Management am Engpass helfen.
- Retransmissions ohne RTT-Anstieg: Der Verlust entsteht nicht durch volle Puffer. Denk an fehlerhafte Optiken, Duplex-Mismatch, WLAN-Störungen oder Policer, die hart abschneiden. Erst die Ursache beheben, dann über den Algorithmus nachdenken.
Wie du diese Fragen strukturiert abarbeitest, beschreibe ich in Netzwerkprobleme systematisch eingrenzen – 5-Schritte-Methodik.
Fazit
Reno ist auf modernen WAN-Strecken zu langsam, CUBIC ein solider Standard mit der Schwäche, Puffer zu füllen, und BBR bringt auf langen, verlustbehafteten Strecken oft deutliche Vorteile – verlangt aber einen genauen Blick auf Fairness und Retransmissions.
Die wichtigste Erkenntnis für die Praxis: Der Algorithmus ist nur eine von mehreren Stellschrauben. Ob er tatsächlich bremst – oder doch das Receive Window, die Applikation oder eine fehlerhafte Leitung –, zeigt dir erst ein sauberer Paketmitschnitt.
Du hast eine WAN-Strecke, die einfach nicht liefert, was sie verspricht – und Netzwerk-, Server- und Applikationsteam zeigen gegenseitig aufeinander? Genau solche Fälle analysiere ich auf Paketebene: neutral, nachvollziehbar und mit einem Ergebnis, das auch die IT-Leitung versteht. Das Erstgespräch ist kostenlos – schreib mir einfach über das Kontaktformular.
Fazit – welcher Algorithmus ist der „beste”?
Die ehrliche Antwort: Es gibt keinen universell besten Congestion-Control-Algorithmus. Der richtige Algorithmus hängt von deiner konkreten Umgebung ab.
- Reno ist für moderne Hochgeschwindigkeitsnetze nicht mehr zeitgemäß – außer in sehr spezifischen Legacy-Kontexten.
- CUBIC ist der pragmatische Standard für Linux-Umgebungen und macht in den meisten Unternehmensszenarien einen sehr guten Job.
- BBR ist interessant für WAN-Strecken, Cloud-Verbindungen und Umgebungen mit nicht-kongestivem Verlust – aber nicht ohne sorgfältige Prüfung der Fairness-Auswirkungen in gemischten Netzen.
Was ich aus der Praxis mitgebe: Schlechter Durchsatz auf einer Verbindung ist selten nur ein Netzwerkproblem. TCP-Stack, Congestion-Control-Algorithmus, Window Scaling, Receive Buffer Size – all das spielt zusammen. Bevor du Geld in mehr Bandbreite investierst, lohnt sich ein sauberer Paketmitschnitt und eine strukturierte Analyse.
Wenn du in deinem Unternehmen Performance-Probleme hast, die sich nicht auf Anhieb erklären lassen – oder wenn du nach einem Netzwerkumbau merkst, dass Durchsatzziele nicht erreicht werden – kann eine professionelle Analyse den entscheidenden Unterschied machen. Ein einziger Blick auf den richtigen TCP-Stream-Graph hat schon manchen teuren Hardware-Tausch verhindert.
Das Problem ist reproduzierbar – aber die Ursache bleibt im Dunkeln?
Dann braucht es einen zweiten Blick auf die Pakete. Wireshark kennt die Antwort – manchmal fehlt nur die Erfahrung, sie darin zu lesen.
Als spezialisierter Netzwerkanalyst helfe ich dir dabei:
- Ursachen präzise zu lokalisieren – statt auf Verdacht Hardware zu tauschen.
- Komplexe Packet-Traces auszuwerten und in klare Handlungsempfehlungen zu übersetzen.
- Die Schuldfrage objektiv zu klären – mit Beweisen auf Paketebene, die das Fingerpointing zwischen Netzwerk- und Applikationsteam beenden.
Im ersten Gespräch schauen wir uns gemeinsam die Ausgangslage an: Symptome, bisheriges Troubleshooting und mögliche nächste Schritte. Danach entscheiden wir, wie es weitergeht.
Schreib mir eine kurze Nachricht mit deiner Herausforderung – ich melde mich für ein unverbindliches Erstgespräch.
Du musst das Thema erst intern vorstellen? Hier sind Nutzen und Ablauf einer Analyse zum Weiterreichen (PDF) für deine IT-Leitung oder Geschäftsführung.